
王梦迪:AI自主科学发现卡在验证环节
「普林斯顿大学王梦迪教授在2026外滩大会上指出,大模型擅长给出最可能的答案,却低估长尾分布中的真正新发现。这解释了AI在数学、编程领域进展迅速,却在物理、化学等基础科学领域缺乏原创突破。她认为关键不在模型规模,而在让现实世界变得可验证,团队正搭建自动化实验平台与LabOS。」
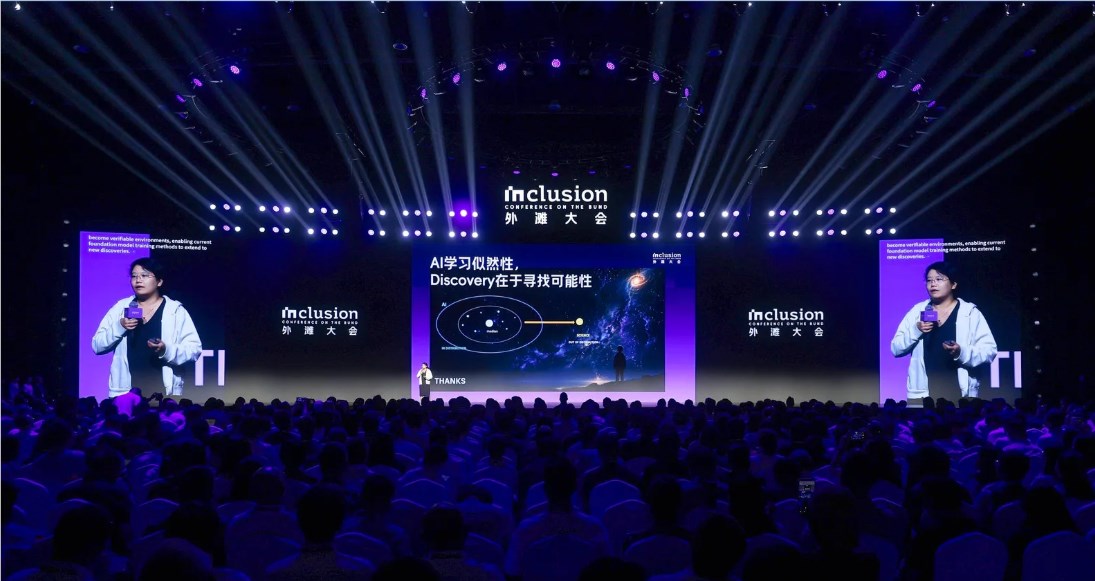
在2026Inclusion·外滩大会主论坛上,普林斯顿大学人工智能创新中心主任王梦迪教授抛出了一个耐人寻味的问题:AI距离自主发现新的科学,究竟还有多远?她的判断并不乐观——今天的大模型虽然已经掌握了海量人类知识,但在真正的科学发现上仍然存在明显局限。
核心矛盾在于,大模型更擅长找到“最可能”的答案,而真正的新发现,往往藏在概率分布的长尾里。
为了验证这一判断,王梦迪团队与普林斯顿大学社会学教授谢宇合作,用ChatGPT、Claude等大模型进行了一系列“模拟人生”实验。例如,让模型模拟一个1930年出生的英国人,自主生成此后的人生轨迹。实验发现,在结婚年龄、职业、性别等多个问题上,大模型倾向于高估最常见的情况,却明显低估少数情况和长尾分布。
“大模型会学到一个概率分布里最大似然的那一点,但对于长尾的知识可能会低估、甚至忽略。”王梦迪这样解释。
这一机制也解释了另一个现象:为什么大模型在数学、Coding等领域进展迅速,却尚未在物理、化学、生物等基础科学领域产生同等规模的原创发现。区别在于,数学和Coding拥有相对明确的“验证器”。代码可以通过编译器和Unit Test验证结果,数学则可以借助Lean等形式化证明系统进行验证。模型能够不断尝试、获得反馈、修正答案,再进入下一轮训练。
但在现实科学研究中,验证远没有这么容易。“Ideas are cheap。你要给我看代码,或者给我看实验。”王梦迪表示。科学研究往往涉及复杂的实验设备、人的判断以及跨团队协作,很多实验甚至无法稳定复现。信息越来越多,并不意味着真正有效的新信息同步增加,反而可能降低科研过程中的“信噪比”。
在她看来,AI走向自主科学发现的关键,并不是让模型再多知道一些,而是让现实世界变得越来越可验证。
为此,王梦迪团队正在尝试建立这样的基础设施。在量子材料研究中,他们搭建了自动化实验平台,将原本需要科研人员数月完成的石墨烯实验流程进行自动化,并把实验设备和能力封装成API,让其他科研机构能够调用和复现实验。与此同时,团队还在探索面向科研实验室的智能操作系统LabOS,让多模态AI能够通过智能眼镜感知实验环境、辅助科研人员操作,并进一步连接软件、AI模型、机器人和真实实验设备。
王梦迪认为,真正决定AI能否成为“发现者”的,不只是模型有多大,而在于是否存在一套能够连接假设、验证、追溯和重复的基础设施。只有当物理世界中的实验过程能够被系统记录、持续验证、反复复现,AI才可能真正把训练中学到的“似然性”,转化为对“可能性”的探索。
这一思路为AI for Science提供了一条不同于“堆参数”的路径:与其期待更大的模型自动涌现科学洞见,不如先为模型搭建一个可交互、可验证、可复现的真实实验环境。当假设与实验之间的闭环被打通,AI或许才能真正从知识的整理者,成长为科学的发现者。
来源:Heooo AI工具导航