
Alpha-R1开源:8B小模型颠覆金融资产配置
「财跃星辰联合上海交大开源金融推理大模型Alpha-R1,基于8B参数与独创“语义门控”技术,在标普500等任务中大幅领先通用模型与传统方法,实现动态策略筛选与可解释决策。」
近日,界面财联社旗下大模型科技公司财跃星辰联合上海交通大学安泰经济与管理学院花成副教授团队,正式开源发布金融推理大模型 Alpha-R1。该模型以仅80亿参数的轻量级架构,凭借创新的“语义门控”推理机制和两阶段强化学习训练框架,在多个真实金融场景的样本外评测中展现出显著优势。
传统资产配置方法常受限于静态统计逻辑,难以适应快速变化的市场环境;而通用大模型虽能处理海量财经文本,却缺乏将信息转化为有效投资决策的能力。Alpha-R1 的核心突破在于弥合了“理解”与“应用”之间的鸿沟——它不仅能实时解析市场状态,还能动态匹配契合当前行情的配置策略。
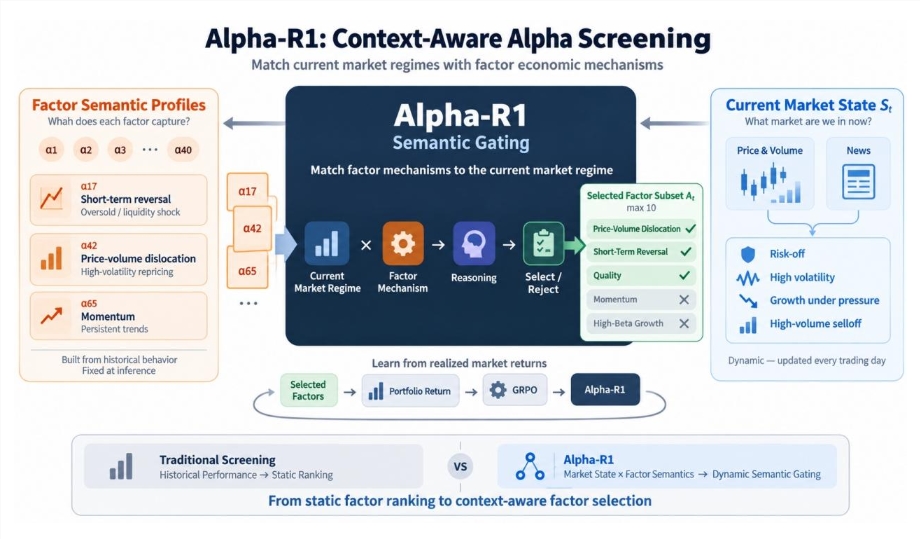
具体而言,Alpha-R1 引入“语义门控”技术:在每次决策前,模型综合实时行情与历史新闻生成精准的“当前市场状态描述”,再将上千条候选策略所附带的“经济逻辑说明书”与之进行语义匹配,仅保留逻辑一致的策略用于配置。这一机制避免了对所有策略平均用力的弊端,实现了智能环境识别与策略启用。
在训练方面,Alpha-R1 采用两阶段流程:第一阶段通过数值方法筛选候选策略池,第二阶段由模型进行语义复筛,并结合 GRPO 强化学习持续优化,其奖励信号直接来自全真模拟环境下的真实收益。消融实验显示,若移除强化学习模块,标普500任务的年化收益从47.87%骤降至12.85%,凸显后天训练对模型能力的关键作用。
在2025年全年未见数据的样本外测试中,Alpha-R1 在标普500和沪深300任务上分别取得远超 DeepSeek-R1(21.94% vs 47.87%)及多种传统机器学习方法的表现。更值得注意的是,即便面对训练中从未接触的罗素2000与中证1000股票池,模型仍保持强大泛化能力。
此外,Alpha-R1 注重决策可解释性。例如在2025年4月9日美股恐慌抛售日,模型准确识别市场状态为“短期波动放大”,优先启用价格偏离类策略,并明确说明长周期策略不适用的原因,为人类专家提供可复核的逻辑链条,有效降低“黑箱”风险。
目前,相关论文、代码与模型已全面开源,研究团队亦通过 block-bootstrap 统计检验和 BM25关键词证伪实验确保结果严谨可靠。这一创新范式有望推动智能投研、风险监测等专业金融场景的技术升级。
来源:Heooo AI工具导航