
京东开源可交互视听世界模型EchoWM
「京东在JDD大会上发布JoyAI-Echo1.5超长音视频生成模型与可交互视听世界模型EchoWM,并宣布开源。前者支持10分钟以上高质量音视频生成,后者实现720P原生音视频联合生成与多轮连续用户交互,在WBench Navigation评测中包揽前两名。」
在近日举行的京东全球科技探索者大会(JDD)上,京东探索研究院正式推出 JoyAI-Echo 系列的两项重大技术进展:超长音视频生成模型 JoyAI-Echo1.5 与可交互视听世界模型 EchoWM,并同步开源后者,标志着 AI 内容生成正从“可观看”迈向“可进入、可探索”的新阶段。
JoyAI-Echo1.5 的核心突破在于其基于音视频 Memory Bank 架构的设计,能够在长达10分钟以上的多镜头视频生成过程中,稳定保持人物形象、声音特征与叙事逻辑的一致性。该模型通过长视频后训练策略,将推理速度最高提升7.5倍,仅需2张 H200 GPU 即可在480P分辨率下实现每秒24帧的等时生成。此外,内置的 Director Agent 模块还能根据自然语言指令自动完成故事展开、分镜规划、内容审核与成片组装全流程。
而此次发布的开源模型 EchoWM,则聚焦于构建一个真正可交互的视听世界。它融合了两类世界模型的优势:既能响应用户操作持续生成画面,又能同步输出环境音、背景音乐与语音,实现720P原生音视频联合生成。通过统一的“相机意图”机制,EchoWM 支持第一人称导航、第三人称摄像机与主体协同控制,并允许用户进行多轮连续探索。在权威评测 WBench Navigation 中,EchoWM 及其轻量版 EchoWM-Flash 包揽榜单前两名,其中 EchoWM 在涵盖158个复杂多轮导航任务的综合评分中位列第一。
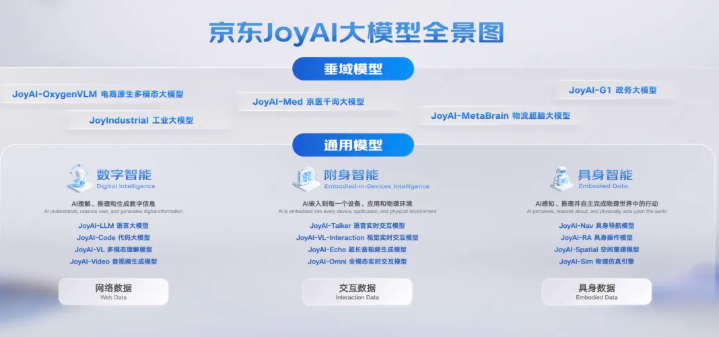
底层支撑方面,京东同步展示了 JoyAI 基础模型矩阵,覆盖图像视频生成、多模态理解、实时交互、世界建模、智能语音及具身操作等能力。即将于10月发布的 JoyAI-Video 模型则进一步强化商业视频生成、物理规律模拟与多镜头连续叙事能力,面向电商广告、短剧创作及具身智能演练等场景。配套的 EgoLive 真实数据集、JoyAI-Sim 仿真工具链与大模型基础设施,共同构成了从真实世界到数字模拟再到模型训练的完整技术闭环。
在产业落地层面,京东已将基础模型能力延伸至零售、物流、医疗、工业与政务五大领域,推出系列行业大模型与智能体,推动 AI 从数字内容生成向物理世界感知与执行深度演进。
来源:Heooo AI工具导航