
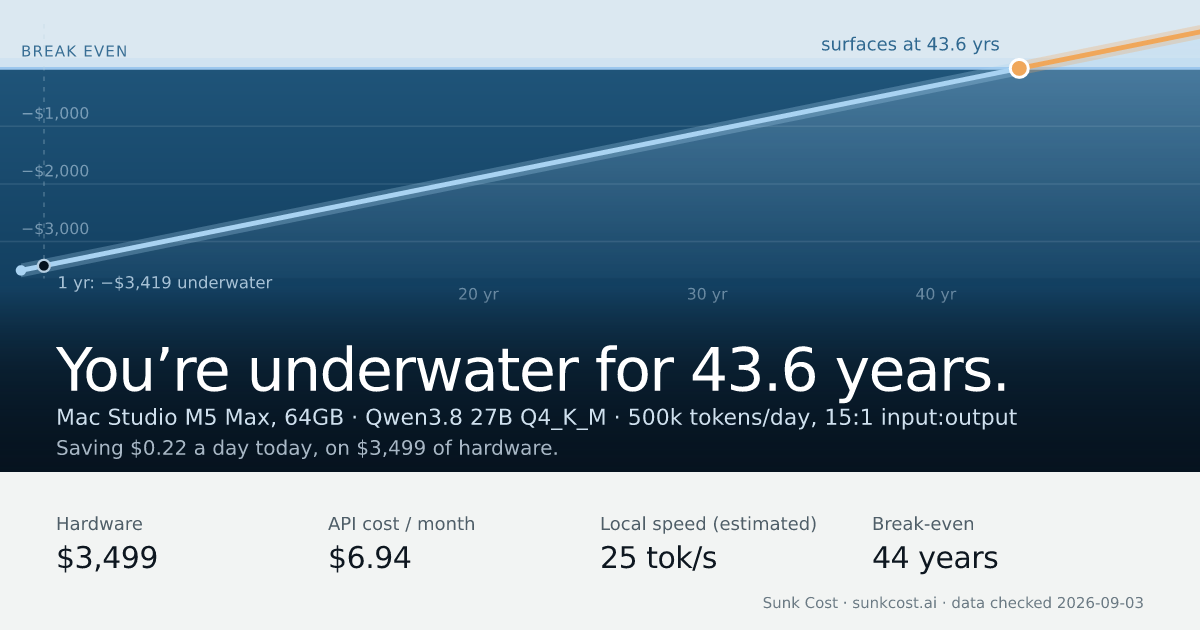
本地大模型回本计算器上线
「Sunk Cost 是一个开源工具,帮助用户估算自建本地大语言模型(LLM)硬件设备的回本周期。通过对比本地推理与云端API的成本和速度,用户可调整参数如模型大小、内存带宽、使用频率等,获得个性化分析结果。」
随着大语言模型(LLM)的普及,越来越多开发者和企业开始考虑部署本地模型以降低成本、提升隐私安全性。然而,自建本地 LLM 推理设备需要一次性投入较高的硬件成本,是否“划算”成为关键问题。近日,一款名为 Sunk Cost 的在线工具在 Hacker News 上引发关注,专门用于计算本地 LLM 设备何时能“回本”。
Sunk Cost(sunkcost.ai)的核心功能是通过对比本地运行 LLM 与调用商业 API(如 OpenAI、Anthropic 等)的总成本,估算出硬件投资的盈亏平衡点。用户只需输入预期的模型规模、显存配置、使用频率等参数,工具即可自动计算出回本所需的时间。对于尚未实测的本地推理速度,该工具采用“内存带宽 ÷ 每 token 所需字节数”的估算方法,并明确标注为预测值,确保透明度。
该工具的设计理念强调灵活性与可定制性。用户可以自由调整多项假设条件,包括每千 token 的 API 成本、本地电力消耗、GPU 折旧率、每日生成 token 数量等。这种高度可配置的特性使得 Sunk Cost 不仅适用于个人开发者,也能为小型团队或初创公司提供决策参考。
值得注意的是,Sunk Cost 并不直接比较模型性能或输出质量,而是聚焦于经济性与时间效率。其时间对比仅受 API 响应速度影响,而本地推理速度则基于硬件理论带宽估算。这意味着用户在评估时仍需结合实际应用场景——例如对延迟敏感的任务可能更倾向本地部署,即便短期成本更高。
该项目目前以开源形式发布,代码托管于 GitHub,鼓励社区贡献与改进。开发者表示,未来计划加入更多模型架构支持(如 MoE、量化模型)、多 GPU 配置选项,以及更精细的能耗模型。对于正在犹豫是否投资本地 AI 硬件的用户而言,Sunk Cost 提供了一个数据驱动的决策框架,有助于避免“沉没成本”陷阱。
随着开源模型生态的成熟(如 Llama 3、Mistral、Qwen 等),本地部署的门槛持续降低。Sunk Cost 此类工具的出现,标志着 AI 基础设施决策正从“技术可行”迈向“经济合理”的新阶段。
来源:Heooo AI工具导航