
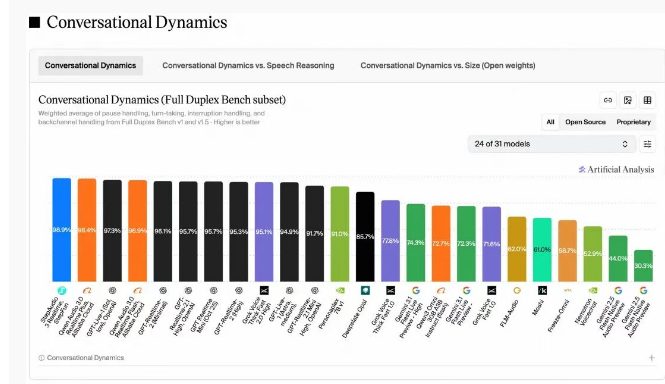
阶跃星辰发布StepAudio3系列五款模型
「阶跃星辰发布StepAudio3系列五款模型,涵盖Realtime、ASR、TTS、Gen与Music,均已上线开放平台。Realtime对话动态综合得分98.9%、语音推理准确率99.7%,ASR词错率1.7%,三项均居全球第一,覆盖从实时语音交互到音乐创作的全场景。」
阶跃星辰正式发布StepAudio3系列模型,一次性推出StepAudio3Realtime、StepAudio3ASR、StepAudio3TTS、StepAudio3Gen和StepAudio3Music五款模型,并全部上线阶跃星辰开放平台。该系列覆盖真人级语音生成、完整音频生成、实时语音交互、复杂语音理解以及音乐创作等场景,其中多款模型在Artificial Analysis榜单中位列全球第一。
其中,StepAudio3Realtime支持原生全双工实时对话,可同时理解语义、语气、情绪、副语言及环境声音,并支持推理与语音生成并行、Tool Call以及长任务异步执行。在Artificial Analysis Conversational Dynamics榜单中,该模型综合得分98.9%,位列全球第一;语音推理准确率99.7%,同样排名全球第一。这意味着语音模型不再只是被动地做单向转写,而是能够在对话过程中同步完成语义理解、情绪感知与语音生成,向真正的实时智能交互体演进。
在语音识别一侧,StepAudio3ASR融合语音识别与大模型上下文理解能力,支持中文、英文、方言、中英混说、长音频,以及医疗、法律、金融等专业场景,词错率仅1.7%,并列全球第一。StepAudio3TTS则强化了音色、语调、节奏、停顿,以及笑声、迟疑、结巴等副语言表现,并支持流式生成,面向实时语音交互场景,让合成语音在自然度与情感表达上更接近真人。
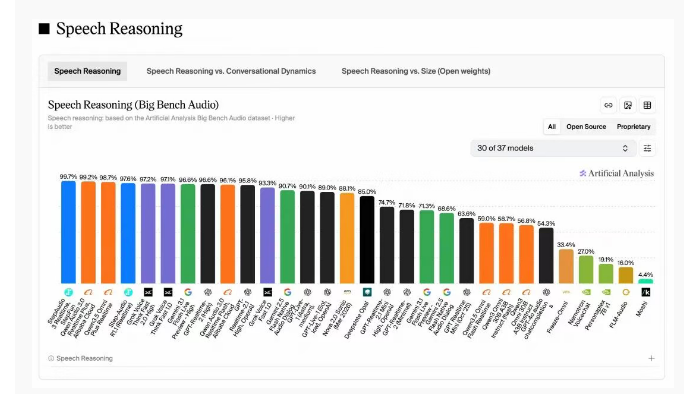
面向音频内容生产的两款模型同样值得关注。StepAudio3Gen可以统一生成角色人声、音效、环境音和背景音乐,并支持多角色及声音时序控制,为音频内容的编排提供统一入口;StepAudio3Music支持歌曲创作、清唱配乐、翻唱,以及基于ABC记谱法的多轮创作,用户可通过自然语言控制曲风、旋律、节奏、乐器和情绪,把音乐创作的门槛进一步拉低。
整体来看,StepAudio3正将语音模型的能力从单一的识别或生成,拓展至完整的音频内容生产与实时智能交互。五款模型同步上线开放平台,也意味着开发者可以直接调用这一整套音频能力,构建实时对话、专业语音转写、配音音效与音乐创作等应用。
来源:Heooo AI工具导航