
千问发布Qwen3.8-Omni-Flash全模态模型
「千问推出新一代原生全模态大模型Qwen3.8-Omni-Flash,支持文本、图像、音频与视频输入及1M长上下文,在30项评测中平均提升超26%,音视频能力接近Gemini3.8Flash,API价格大幅下降。」
千问近日正式上线全新一代原生全模态大模型 Qwen3.8-Omni-Flash,标志着其在多模态AI领域的又一次重大突破。该模型不仅支持文本、图像、音频与视频的统一输入处理,还具备高达100万(1M)token的长上下文能力,已在千问AI平台开放体验。
此次升级重点聚焦于以音视频为核心的 Agentic 应用场景,覆盖视频剪辑、MV创作、影视解说、音视频转图文摘要以及多模态对话等复杂工作流。这使得模型不仅能“理解”内容,还能主动执行任务,显著提升在真实应用场景中的实用性。
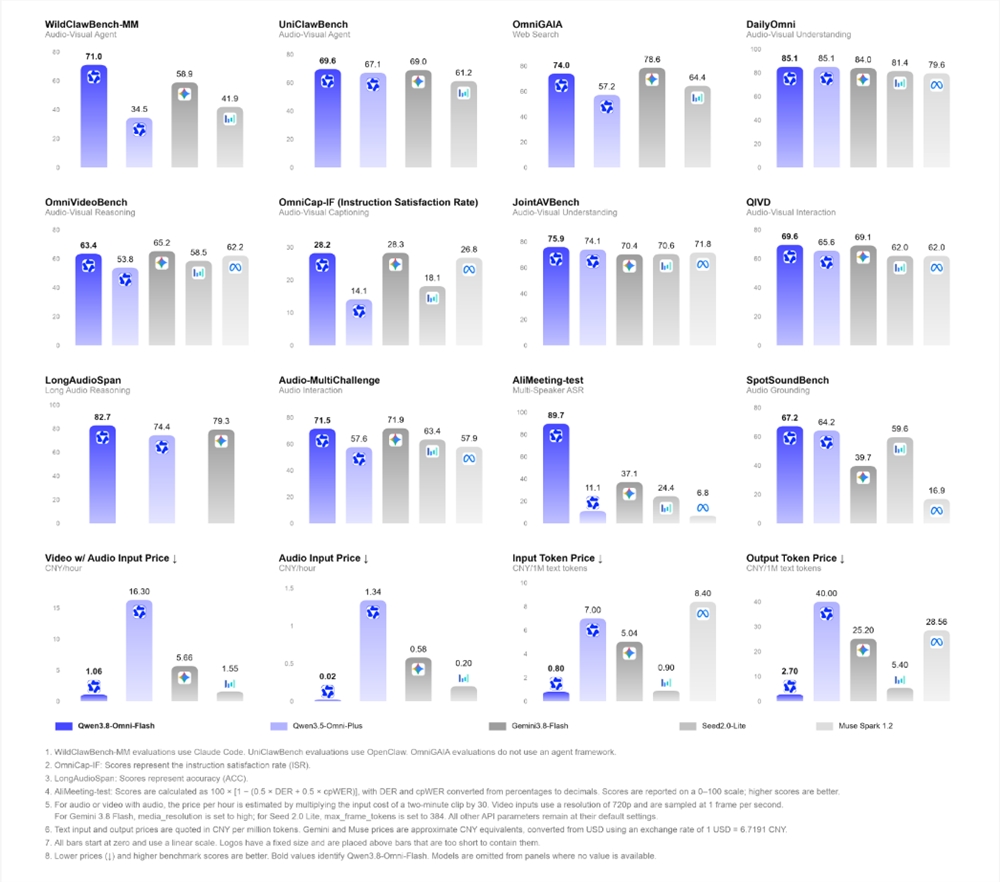
在性能方面,Qwen3.8-Omni-Flash 在累计30项评测中平均得分较上一代 Qwen3.5-Omni-Plus 提升超过26%。其中,WildClawBench-MM 提升36.5分,AgenticVBench 提升22.3分,UniClawBench 达到69.6分。基础能力上,LongAudioSpan 和 OmniVideoBench 分别提升8.3分和9.6分,而 AliMeeting 的 DER/cpWER 指标从88.11/89.61大幅降至3.35/17.18,显示其在会议语音识别上的卓越表现。
官方表示,该模型的音视频综合能力已接近 Google 的 Gemini3.8Flash,音频处理能力甚至整体超越后者。同时,API 成本大幅优化:每小时音频输入价格降幅超98%,音视频输入价格降幅超93%,极大降低了开发者和企业的使用门槛。
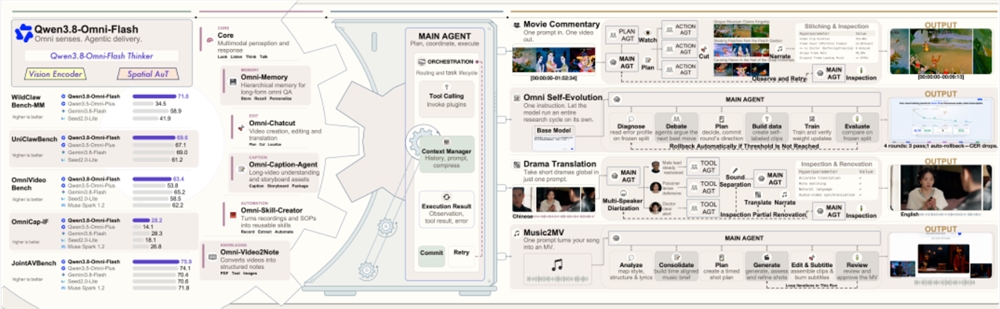
为支撑长程任务与实时交互,千问同步扩展了 Qwen-MM-Plugins 插件体系,并开源了 Qwen-Live Harness 工具链。在 Agentic Understanding 模式下,OmniVideoBench 准确率从63.4提升至67.8,同时 Token 消耗从145,736降至79,117,降幅约45.7%,显著提升效率与经济性。
更值得关注的是,团队将AI能力反哺至研发流程本身:仅用12小时便自主完成评测集选择、数据构建与4轮模型迭代,累计生成3,413条训练数据,成功将 Qwen2.5-Omni-3B 的四川话识别字符错误率从25.79%降至15.30%,相对下降约40.7%。此外,同步推出的 Realtime 版本成为首个支持“听声辨位”能力的全模态大模型,进一步拓展了空间感知与交互的可能性。
来源:Heooo AI工具导航