
千问发布同传大模型,延迟降至2.3秒
「千问团队发布新一代同声传译大模型 Qwen3.8-LiveTranslate,采用音频-文本交织架构与 Thinker–Talker 双模块设计,字均延迟从2.8秒压缩至2.3秒,新增实时说话人分离、原文译文同帧同出与长上下文消歧能力,支持60种语言,API 已上线千问 AI 平台。」
同声传译一直被看作语音大模型最难啃的场景之一:既要听得快,又要译得准,还要说得像原文说话人。千问团队最新发布的新一代同声传译大模型 Qwen3.8-LiveTranslate,正是围绕翻译质量、延迟、说话人识别和语音合成这四个维度做了一次全面升级。
最直观的变化发生在延迟上。该模型采用音频-文本交织的 Interleave 架构,把流式理解、文本输出与语音生成整合为单条因果序列,不再让理解、翻译、合成三个环节彼此排队等待,字均延迟因此从上一代的2.8秒压缩到2.3秒。对于同传场景来说,半秒的差距足以明显改变听感的自然度。
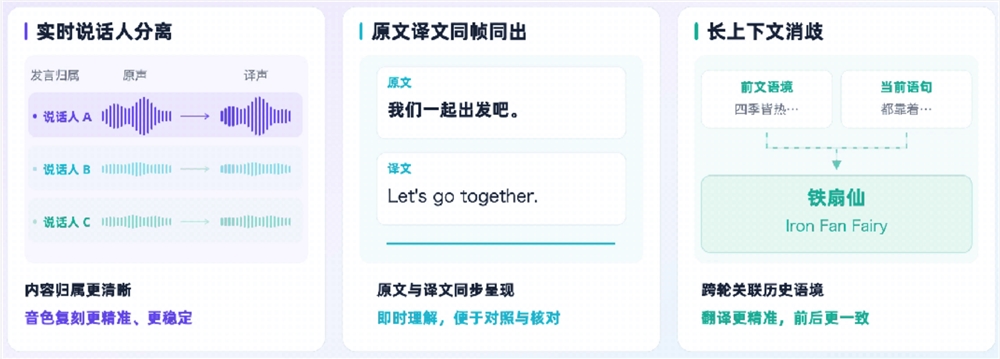
三大新增能力是本次升级的核心看点。其一是实时说话人分离,多人交替发言时每句话的归属都清晰可辨,译文语音还能稳定保留原说话人的音色,而不是统一换成一个机械音色。其二是原文译文同帧同出,双语同步显示既照顾即时理解,也方便用户随时核对原文。其三是长上下文消歧,模型通过跨轮关联历史语境,减少专有名词与指代带来的翻译歧义。
在模型结构上,Qwen3.8-LiveTranslate 采用 Hybrid MoE 的 Thinker–Talker 双模块设计:Thinker 负责理解与翻译,Talker 负责合成保留原音色的译文语音。这种分工让理解与发声各司其职,也让音色保留成为一项可稳定复现的能力,而非偶然效果。
评测环节同样值得关注。在覆盖14个语向的多说话人长音频评测集 Omnilingua-MSpeaker 上,该模型在翻译忠实度、流畅度、简洁度以及说话人分离错误率上,均优于当前主流的实时同传系统,说明其提升并非只在单一指标上生效。
落地方面,模型目前已支持60种语言,API 同步上线千问 AI 平台,开发者可以直接调用这套同传能力构建自己的实时翻译应用。团队表示,下一步将聚焦端到端时延的极限压缩、跨会话长期记忆以及更多语种覆盖,这三条路线也基本勾勒出实时同传后续的竞争焦点。
来源:Heooo AI工具导航