
中国电信开源Xing4.0全栈国产大模型
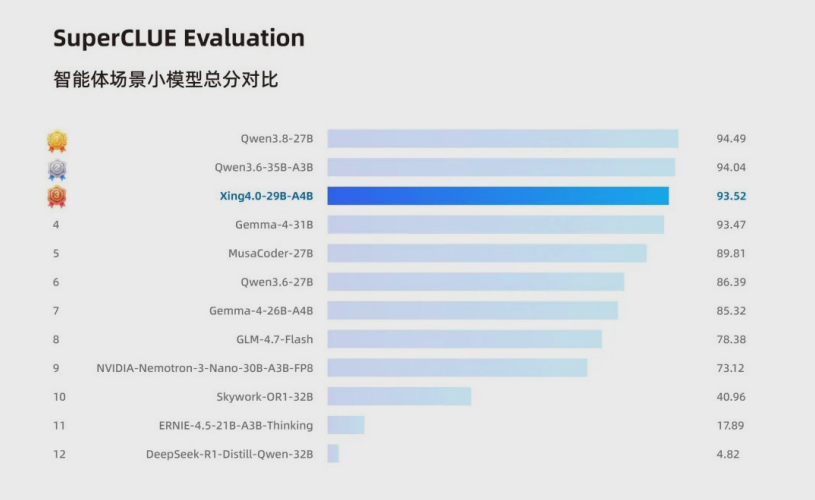
「中国电信开源新一代星辰大模型Xing4.0-29B-A4B,总参数29B、激活参数仅4B,原生支持256K上下文并可扩展至512K。该模型从昇腾芯片训练到推理部署实现全栈国产,SuperCLUE智能体评测得分93.52位列第3,4-bit量化后显存占用仅15GB,消费级显卡即可本地运行。」
中国电信正式开源新一代星辰大模型 Xing4.0-29B-A4B。这是一个总参数规模 29B、激活参数只有 4B 的混合专家模型,原生支持 256K 上下文长度,并具备向 512K 扩展的能力。官方给它的定位很明确:国内第一个从训练芯片到推理部署全程国产,并且专门针对复杂工程任务打磨的百亿参数级大模型。对开发者社区来说,这意味着又一位重量级选手登上了开源牌桌。
整份技术方案里最硬的一点,是所谓的全栈国产闭环。训练侧由昇腾芯片承担算力,中间的适配工作交给国产框架完成,模型架构自研,工具链与生态则通过开源释放出来。从底层算力到上层框架,整条链路没有一处依赖海外供应链。对于长期受制于算力供给的国内团队而言,把全流程攥在自己手里,其价值并不亚于单纯把参数量堆得更高,因为这意味着模型可以被持续迭代、被反复优化,而不必担心某个环节突然断供。
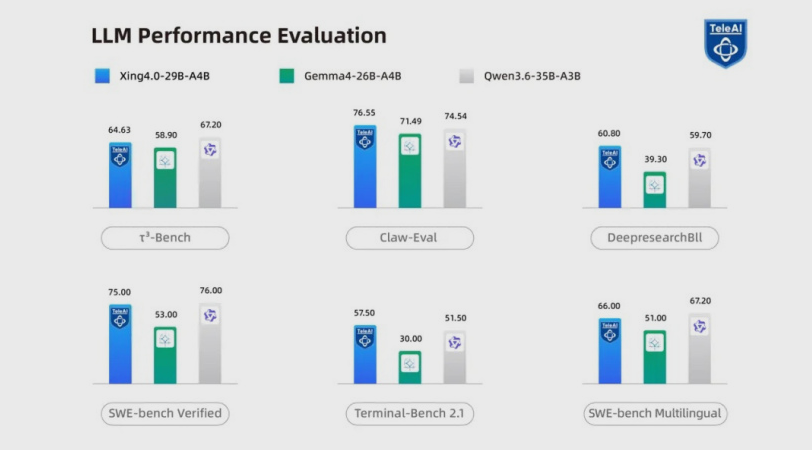
成绩单也撑得住门面。在 SuperCLUE 评测中,Xing4.0-29B-A4B 的智能体能力拿到 93.52 分,位列第 3,与前两名的头部 Qwen 模型差距都不到 1 分。作为一个激活参数只有 4B 的轻量级选手,它在复杂工程任务上的表现已经贴到了第一梯队的背后。这种以小博大的参数效率,恰恰是当下开源社区最看重的方向:推理成本更低,部署门槛更友好,却依然能完成多步骤规划、工具调用这类高难度任务。
更讨开发者喜欢的是它的亲民门槛。经过 4-bit 量化之后,模型的显存占用被压到 15GB 左右,相比 FP16 节省约 75% 的空间。这意味着单块 24G 显存的 RTX3090 或 RTX4090 这类消费级显卡,就能在本地跑起长上下文任务,不用堆服务器,也不用长期租用云端算力卡。对个人开发者和中小团队来说,过去只能围观的大模型长文本能力,如今变成了可以随时上手折腾的本地工具。
开源姿态同样彻底。模型延续星辰系列既有的开源路线,把主流生态几乎接了个遍:微调环节支持 LLaMA-Factory、MindFormers;推理环节适配 SGLang、vLLM、KTransformers;智能体框架方面则针对 OpenCode、Claude Code、OpenClaw、Hermes 做了定向调优,把各家的格式规范对齐到位。模型权重已经陆续上线 HuggingFace、GitHub、魔搭、Gitee 和魔乐等社区,开发者可以随时拉下来改、拉下来跑,也能直接接入自己已有的工作流。
把这几条线索合起来看,Xing4.0-29B-A4B 传递出的信号相当清晰:国产大模型正在从单点突破走向全链条可控,同时又在参数效率、量化部署和生态兼容上向国际主流开源方案看齐。一个全程用国产算力训练出来的智能体模型,就这样把自己摆进了与全球开源生态同台竞技的位置。接下来的看点,是社区能在它之上长出什么样的应用与微调版本。
来源:Heooo AI工具导航