
Grok语音转录2.0错误率减半不加价
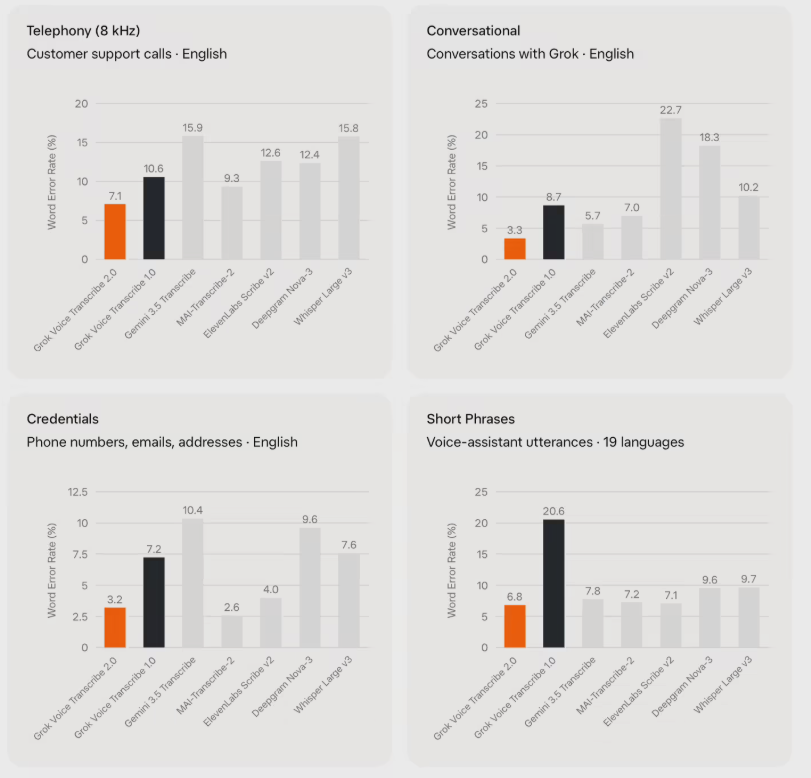
「SpaceXAI 发布新一代语音转文本模型 Grok Voice Transcribe 2.0,错误率较上一代压低约一半,定价保持不变。该模型在 Artificial Analysis 全部 32 款流式模型中准确率排第一,并在客服录音等四个内部数据集上全面超越 1.0 版,说话人分离、精确时间戳与自定义关键词均打包进基础价。」
SpaceXAI 旗下人工智能部门发布了新一代语音转文本模型 Grok Voice Transcribe 2.0。这一版本最引人注目的地方在于,它在把错误率压低约一半的同时,定价一分未涨,延续了 Grok Voice 系列在开发者群体中的口碑路线。
与不少只停留在实验室跑分阶段的模型不同,Grok Voice Transcribe 2.0 扎根于 Grok Voice 底层的音频基础模型,而这套底座已经被深度嵌入真实业务之中:每天接住数万通客服电话,转录数百万小时的视频旁白,还驱动着实体硬件里的各类语音智能体,其中就包括特斯拉车机上的 Grok 助手。
换句话说,它不是实验室里跑分的模型,而是已经在业务一线被海量真实语音反复打磨过的产物。真实业务带来的噪声、口音、语速变化与多人对话场景,构成了模型迭代最直接的验证来源,也让这一代模型的提升有了可追溯的工程依据。
在第三方评测机构 Artificial Analysis 的公开榜单上,Grok Voice Transcribe 2.0 在全部 32 款流式模型里准确率排到第一,把同赛道对手甩在身后。对于流式语音识别而言,准确率与延迟往往难以兼得,能够在实时输出场景下取得这样的成绩,意味着其在解码策略与音频建模上都有实质优化。
SpaceXAI 并不满足于公开基准,还从自家线上业务中抽样构建了四个内部数据集做系统评测,覆盖客服电话录音、与 Grok 的日常英语对话、口述电话号码与邮箱地址这类结构化信息,以及多语种短指令。结果显示,2.0 版在这四个数据集上对 1.0 版实现了全面超越,说明性能提升并非只对单一场景有效,而是在不同语音分布上都具备泛化能力。
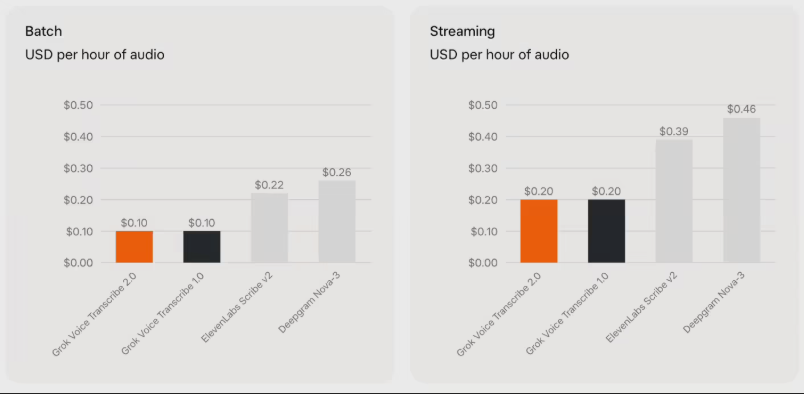
真正让开发者动心的是价格。批量转录仍是每小时音频 0.10 美元,实时流式转录每小时 0.20 美元,与 1.0 版本完全一致;更关键的是,说话人分离、精确时间戳和自定义关键词这几项能力已经全部打包进基础价,不再单独收费。
等于用旧版的价格,买到了错误率近乎减半、还多了功能的新模型。在语音识别这个价格敏感、调用量巨大的赛道里,这种加量不加价的打法,往往会比单纯刷榜更能撬动落地。
从应用视角看,说话人分离与精确时间戳的免费化,直接降低的是会议记录、播客转写、客服质检这类多说话人长音频场景的接入成本;自定义关键词则让专有名词、产品型号、行业术语的识别有了可控的干预手段。对于正在评估语音链路选型的团队来说,这些能力从增值项变成默认项,会显著改变单位成本的计算方式。
结合流式准确率登顶与定价不变的组合,Grok Voice Transcribe 2.0 更像是一次面向开发者的规模化铺量动作:先用真实业务数据把模型打磨到可用甚至好用,再用价格与功能打包降低迁移门槛。语音识别市场接下来的竞争焦点,或将更多集中在单位成本下的综合能力,而不仅是榜单上的一个名次。
来源:Heooo AI工具导航