
B站推AI无限竞技场 百模同台实测
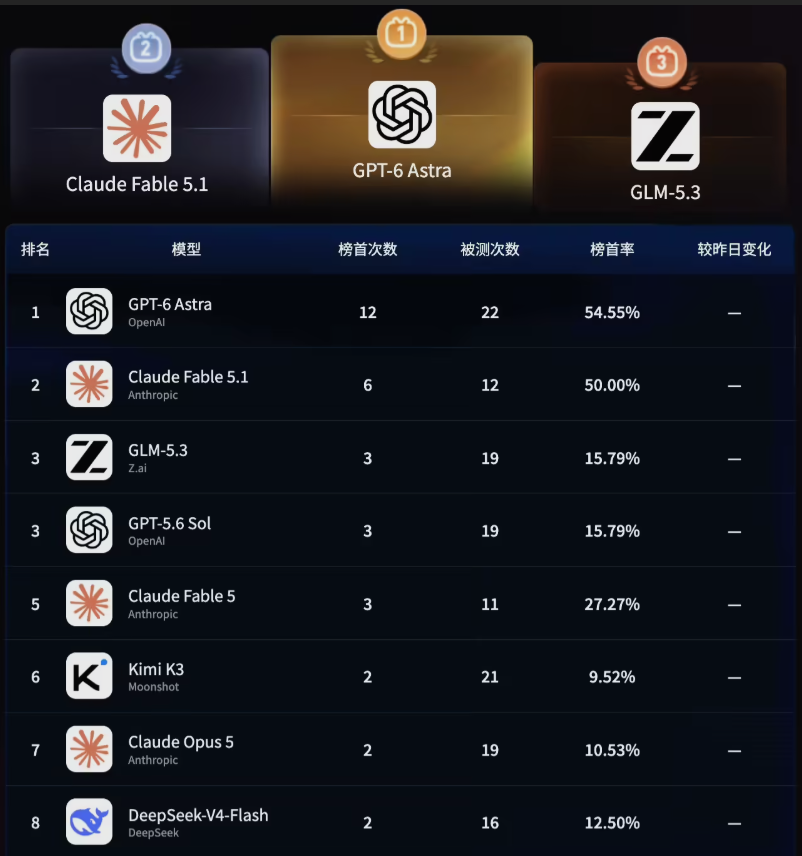
「B站上线“AI无限竞技场”测评榜,汇集上百大模型在真实场景中由UP主实测PK。GPT-6Astra暂居榜首,国产模型占前五三席。该榜单打破传统跑分模式,依托创作者真实工作流与多元命题,实时反映模型实际表现,凸显社区驱动的评测新范式。」
近日,哔哩哔哩(B站)正式推出“AI无限竞技场”测评榜,打造一个由真实用户主导的大模型竞技平台。与传统依赖固定指标的跑分榜单不同,该竞技场汇聚了来自B站各分区的10位UP主,对上百个主流大模型进行多维度、场景化的实战测评。
在首轮公布的排名中,GPT-6Astra凭借综合表现登顶,并成为“登顶次数冠军”,紧随其后的是国产模型GLM-5.3。值得注意的是,榜单前五名中,国产大模型占据三席,展现出中国AI技术在与国际巨头正面交锋中的强劲实力。参与对比的模型包括DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、通义千问、Hy、MiniMax等当前主流产品。
“AI无限竞技场”的核心创新在于其开放性和真实性。它不设固定测评维度,而是鼓励UP主基于自身专业领域或兴趣场景自主命题——无论是代码生成、逻辑推理、多轮协作,还是知识问答甚至创意脑洞,都可作为评测内容。这种源于真实工作流的测试方式,更能反映模型在实际使用中的优劣,也更贴近普通用户关心的“到底哪个好用”这一根本问题。
B站之所以敢于押注这一新型评测机制,底气源自其平台上AI相关内容的迅猛增长。数据显示,过去一年B站AI知识类内容消费时长同比增长72%,月均观看AI相关内容的用户超过1.9亿。围绕大模型的发布、测评、使用教程、问题求助乃至共建生态的内容体系已日趋成熟。
通过将评测权交还给真实创作者和终端用户,B站正尝试构建一个更具参考价值、更贴近大众需求的大模型评价体系。这不仅是对传统基准测试的一次挑战,也可能成为推动AI技术走向普及与实用的重要推手。
来源:Heooo AI工具导航