
Grok 4.7上线:长任务能力升级,价格减半
「SpaceXAI发布Grok 4.7模型,强化长时间任务处理与专业领域表现,在编程、法律、医疗等场景显著提升,同时API价格仅为竞品旗舰一半,主打高性价比知识工作支持。」
SpaceXAI今日正式推出其最新大模型Grok 4.7,定位为“面向编程与知识工作的最强模型”。该模型不仅在推理速度上达到可比模型的两倍,API价格却仅为部分旗舰模型的一半,试图在性能与成本之间建立新的平衡点。
Grok 4.7基于比前代更大的基础架构,并延长了强化学习训练周期,重点优化了长时间任务执行能力。官方强调,新模型在自我检查、长上下文管理以及复杂任务链中的目标一致性方面均有显著提升。这尤其适用于需要数小时完成的软件开发任务——如读取代码仓库、拆解需求、修改多文件、运行测试并反复纠错等场景。
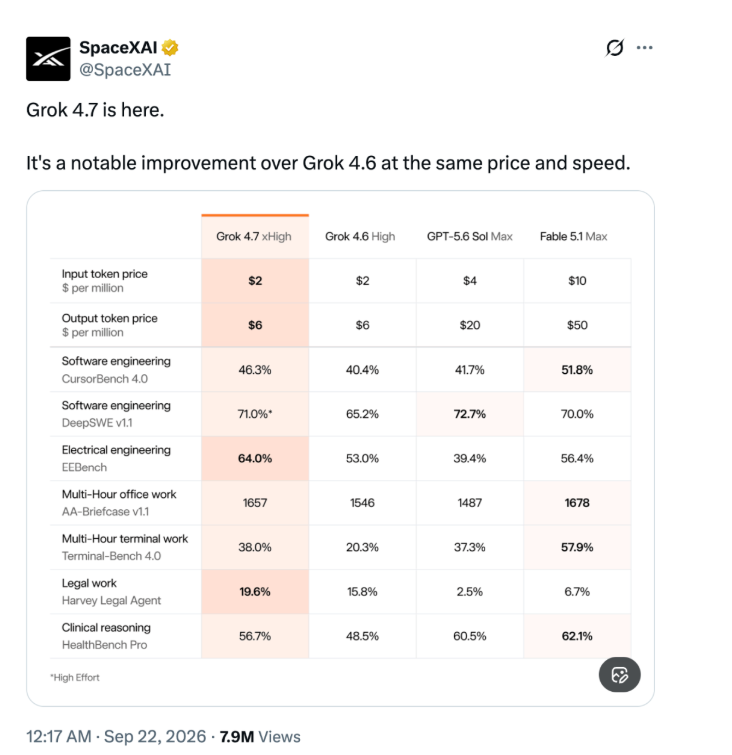
在多项专业评测中,Grok 4.7表现亮眼:CursorBench4.0得分从40.4%提升至46.3%,Terminal-Bench4.0更是从20.3%跃升至38.0%;DeepSWE v1.1高推理强度成绩达71.0%。此外,模型原生支持Grok Bot运行框架,增强了与工具和执行环境的持续协作能力,标志着其从单轮问答向完整工作流支持的演进。
除编程外,Grok 4.7在法律、工程、医疗等专业领域也取得进步。Harvey Legal Agent Benchmark得分由15.8%升至19.6%,HealthBench Professional从48.5%提升至56.7%,EEBench则从53.0%增至64.0%。综合知识工作评测AA Briefcase v1.1得分达1657分,GDPval Elo评分升至1695,接近Fable5.1水平。
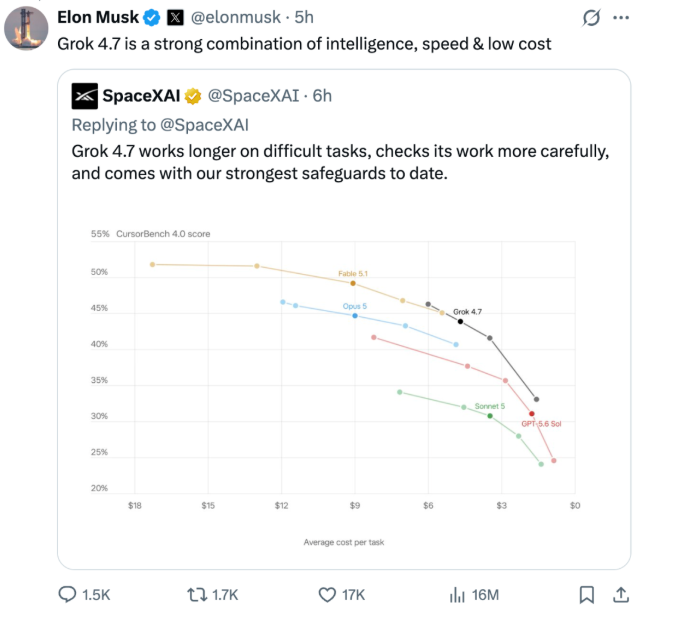
安全方面,Grok 4.7启用全新防护体系,在拒答机制与越狱抵抗上表现最强。其在LatchBio生物安全基准以62.4%登顶,HackerBench v0.3仅放行3.3%的高风险双重用途提示,且误拦率极低。SpaceXAI还向部分网络安全合作伙伴开放邀请制红队测试权限。
定价策略上,Grok 4.7标准版维持每百万输入Token 2美元、输出6美元,快速版速度翻倍但价格未涨。目前该模型已集成至Cursor和Grok Build平台,并通过API及主流云服务开放。尽管部分网友质疑其发布时机,但客观来看,Grok 4.7的核心优势在于以更低的成本提供接近旗舰级的专业任务处理能力,尤其适合需要长时间、高可靠性输出的知识工作者。
来源:Heooo AI工具导航