
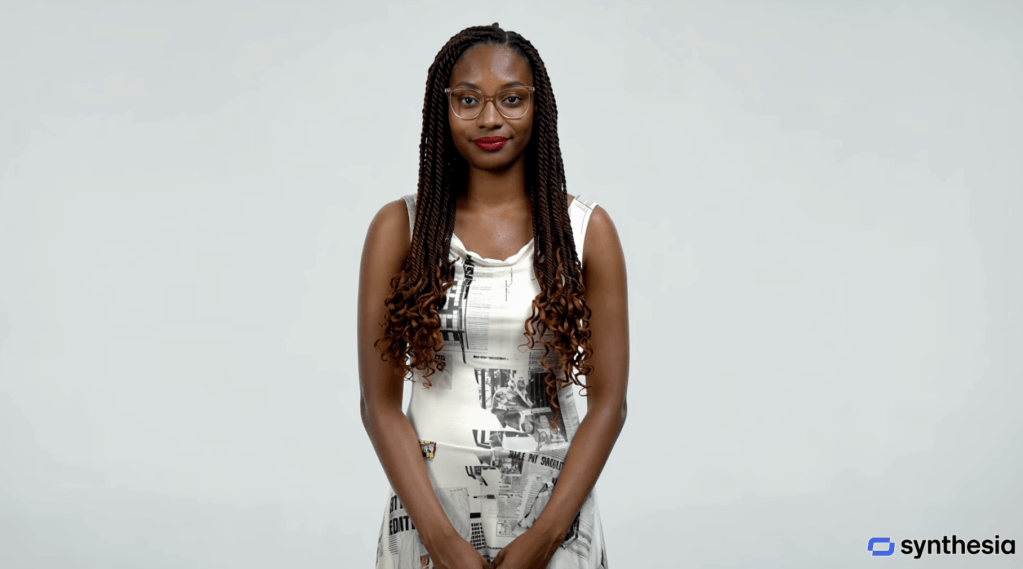
Synthesia推出可对话交互式数字分身
「视频生成初创公司Synthesia为记者打造可对话的交互式数字分身,其技术栈由语音转文本、视频、语言与文本转语音模型组合驱动,仅针对特定文章作答。制作需拍摄大量照片并录制两分钟语音,并签署授权同意。该公司估值达40亿美元,年经常性收入突破1亿美元。」
视频生成初创公司Synthesia的企业事务负责人Alexandru Voica在今年夏天向记者发送了一个链接,介绍公司公关团队的新成员。令人意外的是,这位新成员并非真人,而是Voica本人的交互式虚拟分身。它经过专门训练,能够回答媒体关于Synthesia的常见提问,例如公司做什么、产品如何工作。就在前一天,记者还在一场讨论会上被公关从业者问及是否介意收到由AI生成的投稿,而Voica的分身显然走得更远,这被视为AI在公关场景中应用的进阶形态。
Synthesia最初在英国创立,如今与D-ID、HeyGen、Colossyan等公司同处数字分身赛道。该公司在今年早些时候估值达到40亿美元,并称去年年度经常性收入已突破1亿美元。今年9月,Synthesia邀请记者前往其位于纽约的新办公空间。其核心业务是让企业用AI分身制作交互式培训视频,近期还推出了名为Roleplay Sessions的产品,员工可以借助能够回应的AI分身练习销售话术等场景,分身还会对练习表现进行评分。
在纽约新办公室的活动上,当Synthesia方面询问记者是否愿意拥有自己的AI分身时,记者毫不犹豫地答应了。此前记者对数字分身一直态度平淡,但认为它们终将成为日常在线生活的一部分,也听说过有人在Instagram上创建与自己相似的形象来辅助制作社交内容。正是这种观察,让记者现在愿意把属于自己的数字分身展示出来。
制作流程在一间嵌于Synthesia办公室内的小型摄影棚中完成:团队为记者拍摄了大量照片,并录制了两分钟的语音样本。记者必须就这些分身的制作签署授权同意,随后数字版记者便诞生了。最终产出的分身分为两类,个人分身只会朗读使用者提供的脚本,交互式分身则能够回话并听取提问,而每一类都制作了戴眼镜和不戴眼镜两个版本。
从技术实现看,这些交互式分身由语音转文本、视频、语言模型与文本转语音模型的组合驱动。其技术栈包含Synthesia自有的视频与语音模型,同时公司也允许客户选用来自Cartesia、ElevenLabs、Google等其他实验室的替代方案。这种多模型可插拔的设计,让企业在音色、口型与语言理解等环节拥有更灵活的选择空间,也意味着数字分身的质量并不完全取决于单一厂商的模型能力,而更像是一套需要组合调优的工程体系。
为了让分身具备明确的知识边界,团队挑选了一篇文章用于训练,内容是记者关于获得风险投资的初创公司为何比未获风险投资的初创公司更容易出现欺诈行为的报道。这个交互式分身只会回答与该文章相关的问题,例如为什么记者决定写这篇报道、研究论文讲了什么、研究者发现了什么。这种把回答范围严格限定在特定语料上的做法,既降低了模型跑题与幻觉的风险,也让分身更像是一个可对话的内容入口。
值得注意的是,这是Synthesia首次为记者制作数字分身,此前该公司也只曾为Voica本人制作过类似的交互式形象。对企业而言,这类分身意味着培训、客服与内部沟通等场景可以交给能够实时应答的虚拟形象来完成;对内容生产者而言,它则提供了一种让作品以对话形式被提问的新接口。当分身能够基于特定语料作答并限制回答范围时,如何界定它代表的是本人、公司还是原始内容,也随之成为开发者与使用者需要共同面对的问题。
来源:Heooo AI工具导航