
不繁简历
不繁简历是AI原生简历编辑器,让每句话都有分量。提供智能优化、JD匹配、ATS检测、一键排版、中英互译与职业照生成等功能,已服务超1000万用户,助力高效求职与offer获取。
不繁简历 介绍
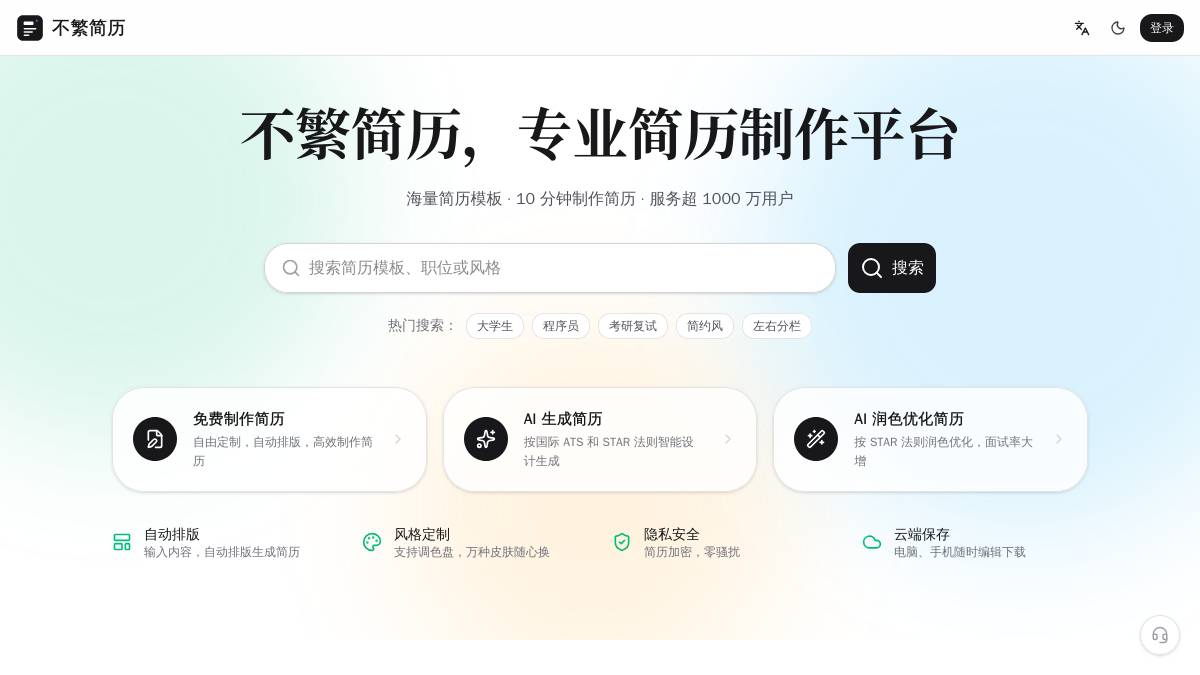
不繁简历是一个专业的在线简历制作与优化平台,核心定位是帮求职者快速搞定高质量简历。平时我们写简历最怕描述干巴巴,或者为了调字体间距花大量时间,它能直接用人工智能技术把这些麻烦事都理顺。平台内置了海量精心设计过的版式,从经典到创意风格都有覆盖,你只需要专注把个人经历填进去,剩下的交给系统自动处理,非常适合那些需要快速产出规范排版文件的群体。
它的典型使用场景非常广泛,不管是应届生准备暑期实习,还是职场员工想跳槽大厂,甚至考研复试和留学申请都能用到。有个常见问题就是简历投出去石沉大海,它能把你的原始经历按行业共识的重写,让成果描述更有冲击力。同时它还支持中英双语切换,翻译结果会根据职场语境调整术语,让你投递外企或海外院校时显得更地道自然,整体能帮你大幅缩短打磨简历的周期。
在同类工具里,它最大的差异在于把内容创作和机器筛选机制深度结合了。传统编辑器只管页面好看,但这份工具会专门针对企业招聘系统的自动抓取逻辑做优化。它会逐项检查你的版面结构是否利于机器解析,并列出具体的可执行修改建议。这种从底层逻辑出发的设计思路,能让简历不仅排版精美,更能顺利通过初筛关卡。
主要功能
AI智能生成与润色
内置模型能力,能按照科学的表达框架把你的平淡流水账改写成突出业绩的专业表述。系统会自动强化动作力度、补全量化数据,确保每一句话都能清晰展现你的实际贡献,有效降低阅读者的信息获取门槛。
ATS深度检测与JD匹配
当你收到心仪岗位的招聘要求时,可以直接把文本贴进系统,让它自动调整措辞重点来精准契合需求。同时还会逐项扫描排版细节和核心词汇覆盖率,输出一份带评分的体检报告与具体修改清单,彻底告别盲目海投。
一键导入与双语转换
如果你手头已经有老旧的文件,直接交给系统就能自动拆解成结构化模块,省去重新手打填表的繁琐过程。另外它还提供高质量的上下文翻译引擎,支持中英文互相转换,外语输出流畅且完全贴合母语者的书写习惯。
云端存储与多端同步
所有编辑进度都会实时保存在服务器里,即使浏览器意外关闭或者网络中断也能自动重试恢复。你在台式机上写的稿子,换个移动设备打开依然接着上次的位置继续修改,随时可以生成高清文件或分享链接。
使用场景
求职者将日常工作经历转化为专业表述
原始描述较为平淡,缺乏结构化数据与明确成果,难以通过人工筛选
调用AI润色功能,依据STAR法则重写经历,强化动词准确性并补充量化指标
针对特定岗位进行简历内容定向调整
海投同一份简历导致各岗位匹配度低,需根据具体招聘要求调整重点
使用JD匹配定制功能,输入目标岗位描述,由AI自动优化措辞与核心重点以契合该岗位需求
排查简历在机器筛选环节的拒收原因
简历多次提交未获反馈,疑似因格式不规范或缺失系统抓取关键词而被过滤
启用ATS深度检测模块,扫描整体结构与关键字覆盖率,获取可执行的修改清单
使用建议
建议正在密集投递求职的朋友优先尝试它的岗位匹配功能,把每天收到的招聘启事直接喂给系统,能快速拿到针对性强的高转化版本。平时练习写作或者不知道从何下笔写项目经历时,可以直接去范例库挑一份同行业的参考底稿,顺着框架填充自己的真实数据即可。
如果遇到需要紧急提交外文材料的情况,直接使用它的翻译模块会比逐句对照字典效率高许多,且不容易丢失专业术语的本意。对于担心隐私泄露的用户,可以放心使用它的加密保存选项,系统明确承诺零骚扰政策,让你在放松的状态下专心完善作品。
常见问题
用户评分
为此工具评分
相关工具推荐


LinkPix
LinkPix 是一个专为 **个人创作者、小红书博主和内容营销者** 设计的**AI驱动的智能外链生成工具**。它的核心使命是帮助用户将社交媒体内容(尤其是小红书笔记)快速转化为可追踪、可变现的个性化落地页,提升流量转化效率。 通过一键生成专属链接页面,LinkPix 自动聚合用户在小红书等平台发布的多篇内容,支持添加商品链接、联系方式、预约表单等转化
LinkPix
LinkPix 是一个专为 **个人创作者、小红书博主和内容营销者** 设计的**AI驱动的智能外链生成工具**。它的核心使命是帮助用户将社交媒体内容(尤其是小红书笔记)快速转化为可追踪、可变现的个性化落地页,提升流量转化效率。 通过一键生成专属链接页面,LinkPix 自动聚合用户在小红书等平台发布的多篇内容,支持添加商品链接、联系方式、预约表单等转化


最新资讯
智能体AI验证与自改进机制研究
arXiv新论文提出一种形式化框架,用于分析智能体AI系统在验证与自改进过程中的能力边界。该研究区分了不同改进机制,并通过有界验证、随机性控制和复杂性类分析,揭示了自改进行为对正确性、证据要求及资源消耗的影响。
LLM智能体受限自演化与准入闸门机制
一项arXiv研究提出,自我改进的LLM智能体若重写自身,会破坏监管者所依赖的变更记录。研究者将自演化限定在运行时挂架层,模型权重保持不变,并设计带哈希链记录的准入闸门。仿真中闸门仅接纳7449个候选变更中的144个,且无一致命错误恶化。
智能体可控遗忘机制实现上下文可逆压缩
arXiv论文提出智能体控制的遗忘机制,让模型把冗余的工具返回结果替换为简短笔记并存入可恢复归档,无需任务训练。在OpenTelemetry调试实验中,提示词token从912492降至231951,成本从约4.38美元降至约1.28至1.44美元,但耗时增加17%,且节省效果依赖具体工作负载。
可解释的表头中心语义表格解读框架
arXiv 上一项研究提出以表头为中心的可解释框架,用于仅有元数据条件下的列类型标注与数据质量评估。该框架把表头映射为39种可解释类型,结合数据质量问题分类体系生成规则化检测,并聚合为数据源级指标 HeadersIQ,在约12万列表头上完成评测。
无模式数据合成框架STS实现企业级智能体训练数据生成
研究者提出无模式数据合成范式STS,让大模型智能体在模拟企业环境中通过调用策略执行API生成数据,由构造保证结构有效性。其通用填充器GP在十个环境中实现0.88平均边际保真度与百分之百约束满足,且无需访问数据库模式,并开源全部框架、环境与数据集。