
Laper 介绍
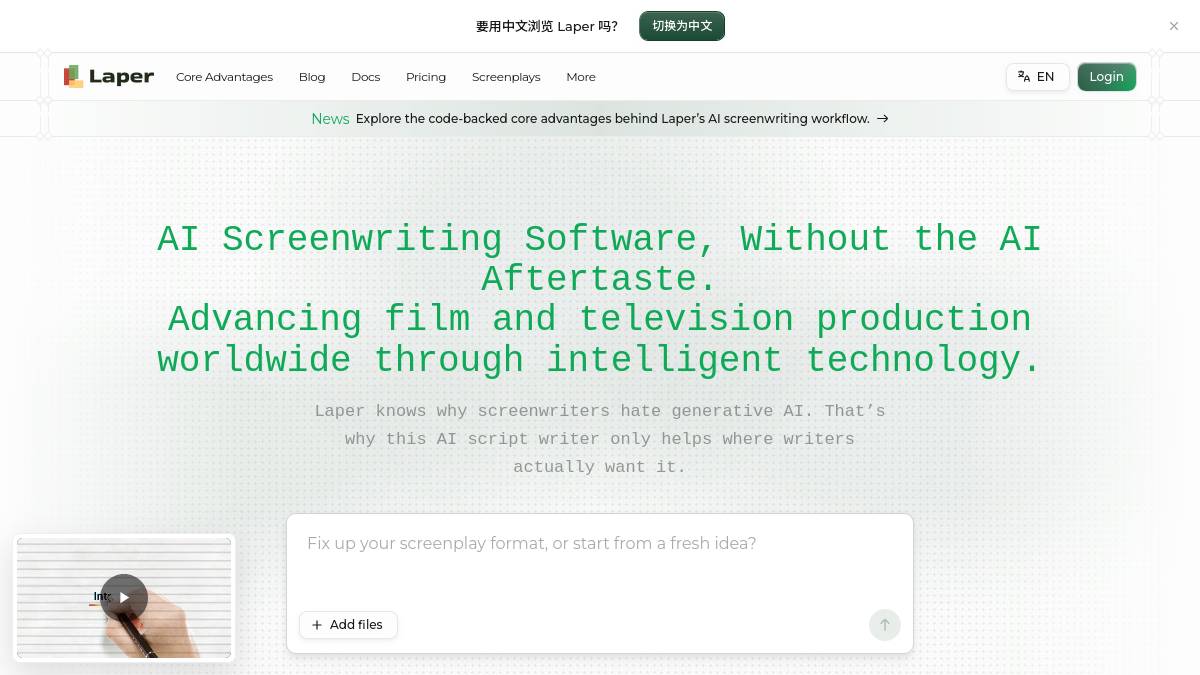
Laper是一个专注于影视剧本创作的AI工具,核心解决编剧使用AI时担心的内容AI违和感问题。
Laper是专门为编剧打造的AI剧本写作工具,针对很多人觉得AI写的内容不够贴合影视剧本专业度的痛点,它只在你需要智能支持时提供帮助,不会破坏你原本的创作习惯,适合有剧本创作需求的各类从业者使用。
不管是个人打磨独立剧本,还是团队协作推进影视项目,Laper都能帮到你。它会自动保留剧本的行业标准格式,还能把场景、人物、故事节点整理成清晰的结构,让你不用在格式调整上花费过多精力,能把更多时间投入到剧情创作本身。
它的核心优势基于技术支撑,专门服务于影视制作领域,不会生成不符合专业规范的内容,和普通通用生成式AI工具相比,更贴合剧本创作的实际需求。
主要功能
剧本格式自动保持
自动维护符合影视行业规范的剧本排版规则,你不用手动调整格式,不会因为排版问题打断创作节奏,专注于内容打磨。
剧本结构可视化
把剧本里的场景、人物、故事节点等核心内容整理成清晰可读的结构,方便你快速梳理故事逻辑,找到需要调整的部分。
实时剧本协作
支持编剧、导演、制片人等不同角色在同一个剧本文件里协同工作,不用反复传递或合并文件,减少协作中的沟通成本和版本混乱问题。
角色场景统一管理
可以记录剧本里的人物设定、地点、道具等信息,帮你统一设定细节,避免剧情里人物特征或场景设定前后不一致的问题。
使用场景
影视编剧创作剧本时
创作影视剧本时需要维持行业统一的格式
使用Laper的剧本格式自动保持功能,由工具处理格式以符合行业规范
影视团队梳理剧本内容结构时
需要梳理剧本中的场景、角色、情节节拍等内容的结构
使用Laper的剧本结构可视化功能,将场景、角色、节拍转化为可读结构
跨角色的影视创作团队协同作业时
编剧、导演、制作人需要基于同一脚本源协同工作
使用Laper的实时剧本协作功能,依托单一脚本源开展协同
使用建议
如果你是专业编剧或者影视项目团队的核心创作人员,在打磨剧本或者和团队协作写剧本时,适合用Laper,它能帮你快速搞定专业格式和协作问题,不用在杂事上浪费时间。
如果你担心普通AI工具写的内容有违和感,不贴合影视剧本的专业要求,那优先用Laper,它的设计更贴合剧本创作的实际需求,不会过度介入你的创作过程。
套餐详情
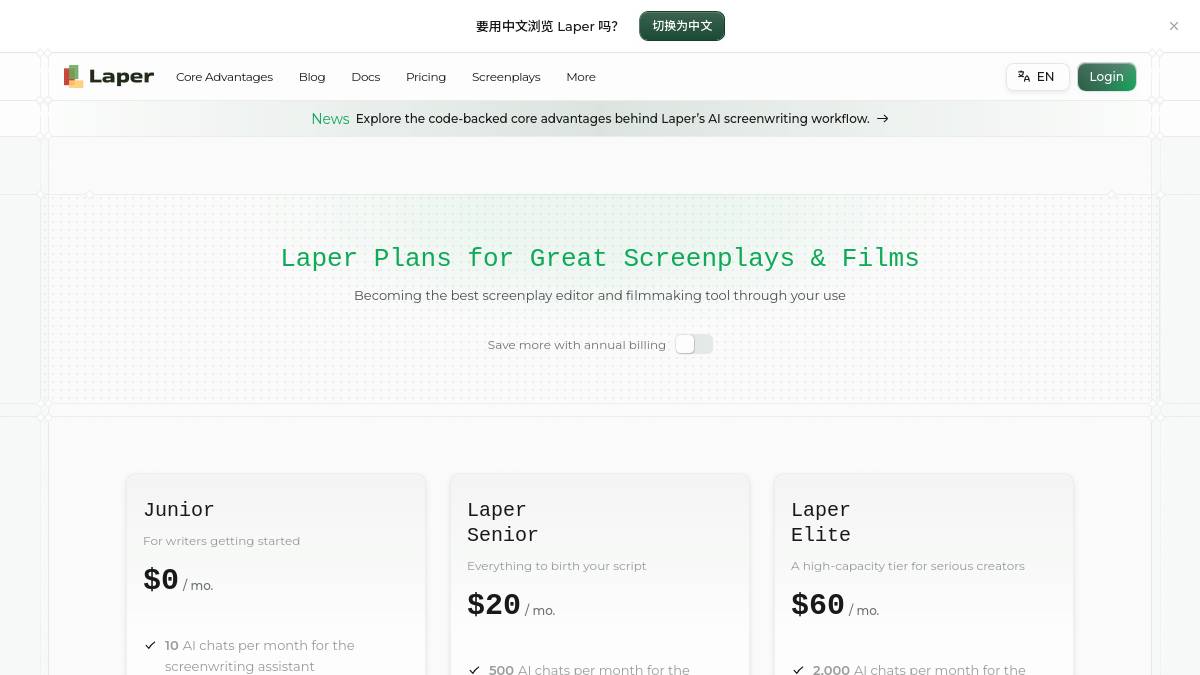
- 每月10次AI聊天(用于编剧助手)
- 每日10次刷新额度
- 2个剧本+2个影视项目
- 基础剧本编辑
- 协作项目
- 当前套餐
- 每月500次AI聊天(用于编剧助手)
- 每月600次图片、视频及更多内容生成刷新额度
- 每日20次刷新额度
- 助手模型:Laper 16mm
- 3个剧本+3个影视项目
- 可雇佣AI编剧顾问
- 协作项目
- 每月2000次AI聊天(用于编剧助手)
- 每月2800次刷新额度
常见问题
用户评分
为此工具评分
相关工具推荐


LinkPix
LinkPix 是一个专为 **个人创作者、小红书博主和内容营销者** 设计的**AI驱动的智能外链生成工具**。它的核心使命是帮助用户将社交媒体内容(尤其是小红书笔记)快速转化为可追踪、可变现的个性化落地页,提升流量转化效率。 通过一键生成专属链接页面,LinkPix 自动聚合用户在小红书等平台发布的多篇内容,支持添加商品链接、联系方式、预约表单等转化
LinkPix
LinkPix 是一个专为 **个人创作者、小红书博主和内容营销者** 设计的**AI驱动的智能外链生成工具**。它的核心使命是帮助用户将社交媒体内容(尤其是小红书笔记)快速转化为可追踪、可变现的个性化落地页,提升流量转化效率。 通过一键生成专属链接页面,LinkPix 自动聚合用户在小红书等平台发布的多篇内容,支持添加商品链接、联系方式、预约表单等转化


最新资讯
智能体AI验证与自改进机制研究
arXiv新论文提出一种形式化框架,用于分析智能体AI系统在验证与自改进过程中的能力边界。该研究区分了不同改进机制,并通过有界验证、随机性控制和复杂性类分析,揭示了自改进行为对正确性、证据要求及资源消耗的影响。
LLM智能体受限自演化与准入闸门机制
一项arXiv研究提出,自我改进的LLM智能体若重写自身,会破坏监管者所依赖的变更记录。研究者将自演化限定在运行时挂架层,模型权重保持不变,并设计带哈希链记录的准入闸门。仿真中闸门仅接纳7449个候选变更中的144个,且无一致命错误恶化。
智能体可控遗忘机制实现上下文可逆压缩
arXiv论文提出智能体控制的遗忘机制,让模型把冗余的工具返回结果替换为简短笔记并存入可恢复归档,无需任务训练。在OpenTelemetry调试实验中,提示词token从912492降至231951,成本从约4.38美元降至约1.28至1.44美元,但耗时增加17%,且节省效果依赖具体工作负载。
可解释的表头中心语义表格解读框架
arXiv 上一项研究提出以表头为中心的可解释框架,用于仅有元数据条件下的列类型标注与数据质量评估。该框架把表头映射为39种可解释类型,结合数据质量问题分类体系生成规则化检测,并聚合为数据源级指标 HeadersIQ,在约12万列表头上完成评测。
无模式数据合成框架STS实现企业级智能体训练数据生成
研究者提出无模式数据合成范式STS,让大模型智能体在模拟企业环境中通过调用策略执行API生成数据,由构造保证结构有效性。其通用填充器GP在十个环境中实现0.88平均边际保真度与百分之百约束满足,且无需访问数据库模式,并开源全部框架、环境与数据集。