PrismML 微型模型适配骁龙智能眼镜
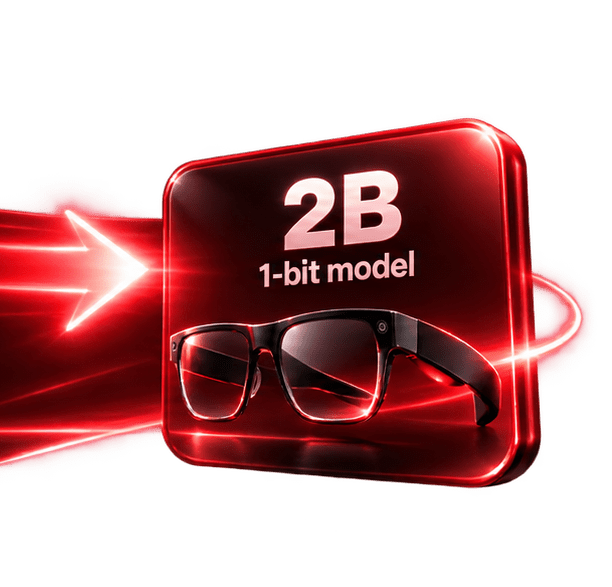
「AI 实验室 PrismML 在高通骁龙峰会上展示了面向智能眼镜的 1 比特 Bonsai 大模型,可在骁龙 AR1 Gen 1 平台上本地运行。该模型为 20 亿参数视觉语言模型,压缩比例达 4 倍且几乎不损失性能,目标是推动开放权重、端侧运行的人工智能。目前尚无搭载该模型的眼镜产品发布。」
在智能眼镜被视为人工智能下一块重要屏幕的赛道上,一家名为 PrismML 的 AI 实验室正在尝试用极小的模型解决算力与隐私的双重难题。这家由加州理工学院研究人员创立、加州大学伯克利分校的 Ion Stoica 担任顾问的实验室,近日推出了专门面向智能眼镜的微型语言模型版本,该版本可在搭载高通骁龙芯片的设备上本地运行。
在高通举办的骁龙峰会上,这家芯片厂商现场展示了 PrismML 的 1 比特 Bonsai 大语言模型。演示设备是基于骁龙 AR1 Gen 1 平台打造的 AI 智能眼镜,模型完全在本地完成推理,不依赖云端服务器。对于一款需要长时间佩戴、电池容量有限的设备来说,端侧完成推理意味着响应更快,也避免了画面与语音数据在网络上来回传输。

PrismML 的核心技术卖点在于极致的模型压缩能力。据此前报道,该实验室能够把更大的模型大幅缩小,在本次智能眼镜版本中压缩比例达到 4 倍,同时在标准基准测试中保留了几乎全部性能。对于在功耗、体积和散热上都严格受限的可穿戴设备而言,这一点相当关键。模型越小,对内存带宽和芯片算力的要求就越低,也就越容易塞进一副普通眼镜的镜腿里。
面向智能眼镜的这一版本是一个 20 亿参数的模型,专门针对视觉与语言任务做了调优。佩戴者可以直接向眼镜提问,询问眼前看到的是什么物体、什么场景,模型在设备端实时给出回答。这种视觉与语言结合的能力,正是智能眼镜最自然的交互方式,用户不必掏出手机拍照再上传,只需要看过去、问出来。

从更长远的目标看,PrismML 想做的是开放权重的人工智能。它希望模型能够直接运行在用户手中的设备上,更充分地利用设备已经具备的算力,而不是把所有请求都送往远程数据中心。这一路线与当前主流的云端大模型形成了明显分野,也决定了它在模型架构、量化方法和推理引擎上必须走一条更极致的优化路线。
这家初创公司把这套思路包装成一种替代方案:与其依赖专有人工智能实验室的隐私承诺,以及它们对更多算力近乎无止境的需求,不如把智能放在本地。模型权重开放、推理在端侧完成,数据不必离开设备,这既降低了对网络和云服务的依赖,也让用户对自身数据拥有更强的掌控力。对于摄像头始终在线的智能眼镜而言,这种本地化处理的价值尤为突出。
为高通芯片发布适配模型,正是这一愿景的落地步骤之一。芯片平台与模型之间的深度适配,决定了端侧推理能否真正做到低延迟与低功耗。骁龙 AR1 Gen 1 平台本身就是为轻量级 AR 眼镜设计的,PrismML 的模型能够在其上跑通,说明超低比特量化模型在真实的可穿戴硬件上具备可行性。当模型压缩技术与专用芯片平台形成合力,端侧人工智能的能力边界会被重新划定。
不过,这项技术距离普通消费者还有一段路要走。目前还没有任何搭载 PrismML 模型的智能眼镜产品正式发布,高通峰会上的展示更多是技术可行性的证明,而非量产信号。对于整个端侧人工智能生态来说,这次合作释放出的信号是清晰的:模型小型化与芯片专用化正在合流,未来的智能眼镜或许不需要把画面和数据传到云端,就能理解用户眼前的世界。开放权重与端侧推理能否成为可穿戴设备的主流选择,还要看接下来有多少硬件厂商愿意跟进。
来源:Heooo AI工具导航