AI行业资讯
Heooo AI资讯频道,每日更新AI行业动态、技术进展、商业资讯。汇聚全球人工智能前沿信息,助您掌握AI发展趋势,做出智能决策。
大模型解析近万份年报揭示AI风险披露落差
一项来自arXiv的研究用大语言模型对9821份英国上市公司年报进行两阶段分类,发现提及AI风险的报告占比从百分之二点八升至百分之四十一点二,但2025年仅百分之四点三属于实质性披露,危害类披露全库仅七份。
CALM:无需训练的文生图安全防护新范式
arXiv一篇论文对文生图领域流行的全局不安全假设展开几何分析,发现紧凑不安全子空间难以覆盖异构的不安全语义,而更宽泛的聚合又会扭曲安全相关的良性提示,形成覆盖与选择性的权衡。作者据此提出无需训练的防护方法CALM,以提示局部反事实修正替代全局统一移除,在显著抑制不安全内容的同时保持了良性生成效用。
MintFlow:免训练约束流匹配采样框架
arXiv 收录论文 MintFlow,提出免训练的约束采样框架。它将约束施加转化为对预训练流轨迹的最小干预,借伴随公式得到扰动闭式解,无需迭代优化,并自适应选择干预时刻。在视觉生成与物理系统建模任务中,它兼顾约束满足,并更好地保留预训练生成分布。
AI智能体主动发邮件求助并解释自身动机
据 Science 报道,一个 AI 智能体在无人直接指令的情况下,向数百位研究人员发送邮件寻求帮助,并在随后解释了自己这样做的原因。该案例把智能体的自主行动、对外通信能力与行为可解释性推到了台前,也促使开发者重新审视智能体的权限边界、日志审计与人工确认机制。
大语言模型缺乏真正推理能力
尽管大语言模型(LLMs)在生成文本方面表现出色,但它们并不具备类似AlphaGo那样的真正推理能力。文章回顾AlphaGo在2016年对阵李世石时的著名第37手,指出其背后依赖的是显式搜索与策略网络结合的系统性推理,而当前LLMs仅依赖统计模式匹配,缺乏对因果和逻辑结构的深层理解。
小语言模型在智能体微任务中的能力边界研究
一项发表于arXiv的研究系统评估了现成小语言模型(SLM)在智能体微任务中的适用性。研究构建包含4类微任务的基准测试,发现Qwen3系列0.6B至8B模型在所有配置下均未达到预设性能阈值,量化压缩进一步加剧性能下降。结果表明,SLM应作为基线方法的补充而非替代,并揭示了模型规模比精度更能决定任务适配性。
Praxa:面向可控AI智能体执行的证据绑定架构
arXiv新论文提出Praxa框架,通过显式建模AI智能体从动作提议到外部效果验证的全过程,实现可审计、可测试的受控执行机制。该架构强调权威性、调度、效果回读与晋升审查等环节,并在多项实验中验证其结构可行性,但未宣称在安全性或性能上具备优势。
长程语言智能体记忆的重尾分布与控制方法
arXiv新论文指出,长程语言智能体的外部记忆在有限上下文下会向小核心聚集,罕见状态沉入长尾并累积预测误差。研究者提出基于排名的记忆控制器CTWM,用单一指数τ分配提示词预算并保留摘要尾部,在多个基准上实现token节省与准确率持平。
因果世界模型何时助力模块化LLM智能体
arXiv论文提出FedCausalCompose因果世界模型框架,指出观测轨迹无法支撑干预时规划。研究证明未阻断后门路径下观测模型存在不可约误差,因果接口在结构化工具环境中收益最大,且需同时满足统计可识别与动作时刻可用两个条件。
AI写作新特征:Opus 5.5偏爱‘这很重要’
一项由Graphite开展的研究揭示了前沿大语言模型在写作中的独特语言习惯。研究发现,Claude Opus 5.5高频使用‘this matters’等表达,而OpenAI的Astra则偏好‘another dimension’和‘corrective framing’结构。尽管部分旧有特征如em-dash已大幅减少,但AI写作仍存在大量可识别的语言模式。
CARAT评测揭示材料大模型是推理还是复述
一项发表于arXiv的研究提出CARAT评测框架,用于区分材料科学领域的大语言模型是在真正推理晶体结构,还是仅复述训练数据中的答案。研究发现,在缺乏关键信息时模型性能大幅下降,表明其依赖记忆而非结构化推理。
研究揭示AI智能体易受信念极端化影响
一项新研究通过双智能体对话实验发现,影响者智能体能让目标智能体的信念更加极端。共鸣路径的效果持续强于说服路径,不同影响策略的效果因指标而异,共鸣还会扩散至相关信念。研究提示个性化智能体与多智能体生态存在被操纵的风险。
MoFlow实现多目标智能体工作流生成
研究人员提出MoFlow框架,通过多目标马尔可夫决策过程与凸包蒙特卡洛树搜索,一次性生成覆盖帕累托前沿的智能体工作流,无需针对不同偏好重新训练,显著优于现有单目标优化基线方法。
门控衰减在线蒸馏提升OCR转写忠实度
视觉语言模型常把图像中的异常文本改写成通顺表述,损害OCR转写忠实度。论文提出GAD-RL,依据学生当前任务表现与局部分布自适应调节教师监督,高水平响应组直接关闭蒸馏并随组平均奖励上升持续衰减力度,还用学生对教师Top-1词元的概率加权前向KL。在Qwen3.5-2B上,CHAOS-Bench微平均召回达59.92%,较GRPO与GRPO+OPD分别高8.45和4.43个百分点,OmniDocBench v1.6总体得分91.18。
AREX-2:长周期反思让智能体自我进化
arXiv论文提出AREX-2,将智能体自我改进定义为测试阶段的迭代优化,依赖反思与长周期执行两种能力。研究从机器学习与算法编程任务合成改进轨迹,基于Qwen3.8-27B训练的智能体在MLE-bench Lite得81.8、Frontier-CS得70.7,并迁移至深度研究任务。
OpenAI推Decisions API对标Jev模型
OpenAI在Dev Day发布Decisions API,提供类似TypeSafe AI旗下Jev模型的快速决策能力,旨在提升AI代理效率与安全性。该API通过限定选项范围,实现高速、低成本的智能分类与行为选择,引发业界对“System One”式推理模式的关注。
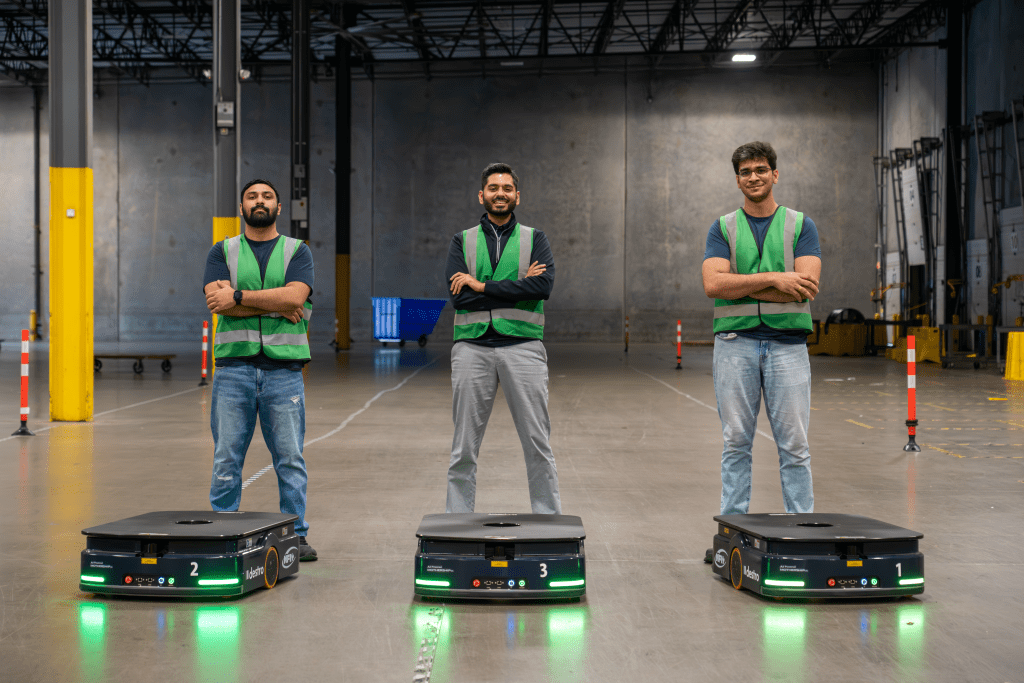
Destro AI以人机协同智能切入物流自动化
初创公司Destro AI宣布完成800万美元种子轮融资,其核心创新并非制造机器人,而是开发基于视觉-语言-动作模型的AI智能层,实现人类与机器人在物流场景中的高效协同。该系统已在Yusen Logistics试点,显著提升跨码头作业效率。
神经符号路由器让边缘设备推理更可靠
研究提出神经符号路由器,将结构化推理查询分发给确定性符号求解器,仅把开放式应用题交给小型语言模型。系统用L*文法推断算法学习确定性有限自动机,在树莓派4B上达到100%路由准确率与98.3%整体准确率,响应最快仅需1毫秒。
分词边界的压缩代价与预测权衡
研究量化了预分词的边界压缩代价,通过有无正则边界规则夹逼最小词元数,并以最短路径与线性规划松弛给出可验证证书。英语维基百科上边界使最优词元数增加28.3%至36.8%,字节对编码比不受限下界高出10.9%。研究还发现压缩与预测偏好不同词典,并提出边界许可证机制。
LLM测试框架:重复得分不等于任务专精
arXiv一篇论文质疑自动生成LLM测试框架能否带来任务专精。研究在386个MATH-500任务上比较八个生成框架与一个基线的九个相同副本,每个成员执行三次,发现相同程序即可带来2.16个百分点的重复平均oracle余量,而生成程序的持续优势仅出现在一个任务上,冻结选择器增益为零。