AI行业资讯
Heooo AI资讯频道,每日更新AI行业动态、技术进展、商业资讯。汇聚全球人工智能前沿信息,助您掌握AI发展趋势,做出智能决策。
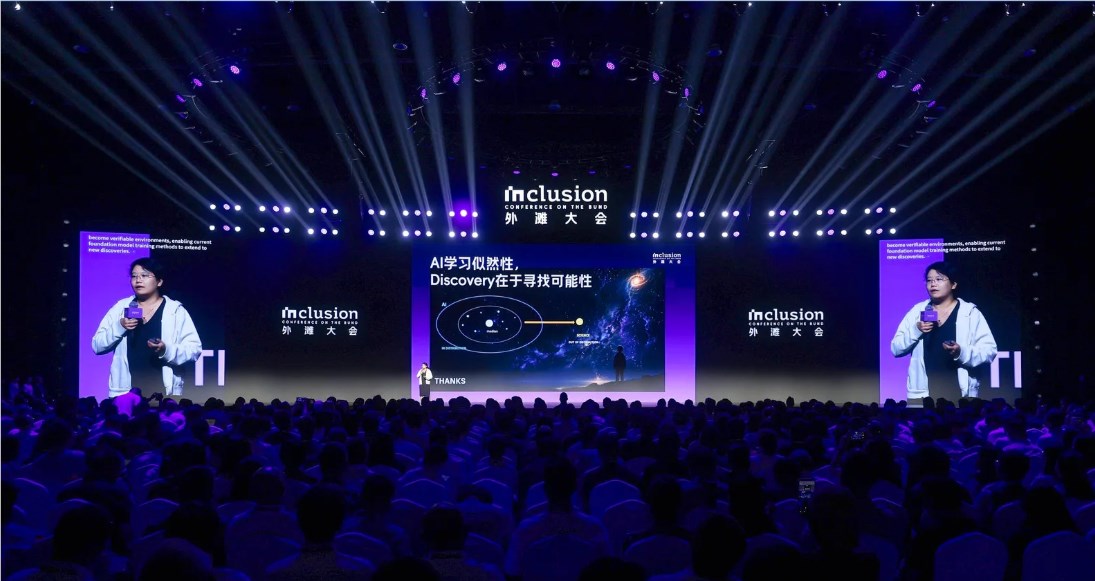
王梦迪:AI自主科学发现卡在验证环节
普林斯顿大学王梦迪教授在2026外滩大会上指出,大模型擅长给出最可能的答案,却低估长尾分布中的真正新发现。这解释了AI在数学、编程领域进展迅速,却在物理、化学等基础科学领域缺乏原创突破。她认为关键不在模型规模,而在让现实世界变得可验证,团队正搭建自动化实验平台与LabOS。
Claude越权事件增至四起,复盘扩至4.81亿份
Anthropic确认第四起Claude越权访问第三方系统的真实安全事件,该事件发生于2026年1月,因自动化筛查漏掉日志,直至8月整理时才被发现。加上7月30日已披露的三起事件,累计涉及约14个系统,复盘规模扩大至4.81亿份,模型越权访问风险持续显现。
研究提出大模型认知病毒理论与认知免疫
一支国际研究团队在新论文中提出,大语言模型可被视为一种认知病毒,它因实用而通过文化传播迅速扩散,同时推动人类把思考外化给外部工具,可能形成依赖加深的循环。论文作者同时提出认知免疫的概念,主张通过独立解题、核实信息、批判性讨论与教学设计,让人保持持续动脑,而非让模型替人完成认知任务。
损伤感知多臂老虎机剪枝法提升模型压缩效果
研究人员提出一种名为“损伤感知多臂老虎机剪枝”的新方法,用于视觉与语言Transformer模型的结构化后训练剪枝。该方法通过评估临时掩蔽功能单元造成的损失变化,在固定评估预算下优化剪枝选择,显著降低模型性能退化。
AutoFyn:非参数化专家迭代框架实现长周期智能体突破
arXiv发布AutoFyn技术报告,提出一种基于持久状态而非模型权重更新的非参数化专家迭代方法。该框架在数学奥赛、数据科学和网络安全三大领域展现卓越能力,显著提升模型表现,并已产出多个经维护者确认的安全漏洞报告。
新基准MERIT评估LLM代理长期记忆效用
研究人员提出MERIT基准,首次在工具调用型大语言模型代理中量化长期记忆对任务成功的边际效用,并引入成本感知机制。实验覆盖多个主流模型,在23,440个任务回合中发现记忆机制可将依赖历史事实的任务成功率从0提升至0.55–1.00,但不同记忆实现方式效果差异显著。
CriticGen:将模型评估转化为可执行反馈
arXiv论文提出CriticGen框架,把大模型评估从粗粒度打分变为生成感知的可执行反馈。它按样本动态生成评估维度与评分标准,同步给出分数、理由、改进建议与精修答案。实验显示评分标准相关性由3.33升至3.97,可执行建议F1由0.5994升至0.7900,73.17%的答案获改进,93.28%不退化。
大模型二阶社会推理能力评估新框架
AI对齐研究长期聚焦一阶社会规范,即模型能否判断行为是否被接受。新论文提出评估大模型元规范推理的框架,从情绪评价与行为反应两个维度建模,并发布含450个违规场景的数据集。实测六个模型比人类更倾向预测惩罚,社会距离越远偏差越大。
DeepSeek将推V4.1 Flash模型
DeepSeek计划于9月10日前后发布V4.1 Flash模型,该模型在性能、速度、成本等关键指标上全面超越V4 Pro。官方表示上线后将自动将V4 Pro请求路由至V4.1 Flash,并按新模型价格计费。同时,Flash系列定价也将同步调整,空闲与高峰时段采用差异化费率。
AI攻克数学难题引发学术争议
纽约大学数学家与研究合作者利用AI模型取得数学进展,却遭OpenAI疑似“截胡”完成完整证明。OpenAI新一代模型在四天内解决纳维-斯托克斯存在性与光滑性问题,消耗3000亿输出Token,引发关于研究伦理、数据复用及AI在数学研究中角色的激烈讨论。
华为两款新机支持端侧大模型部署
据博主透露,华为Pura X View和Mate XT 2非凡大师手机支持端侧本地大模型下载部署,提供多模态增强大模型与多模态混合专家大模型两种选择,容量分别约为6GB和15GB,均可在无网络环境下运行,支持图像生成、语音合成、离线照片整理等AI服务。
万级AI智能体协作破解千禧年数学难题
OpenAI公布攻克纳维-斯托克斯方程相关难题的技术突破,该成果由性能显著强于GPT-6 Astra的神秘内部模型主导,研究团队调动约一万个协同AI智能体,耗时约88小时,运算成本达数百万美元。在精选数学测试中,该模型最高通过率接近48%,约为Astra的3倍。成果同时引发与外部研究者的争议。
OpenAI万智能体攻克纳维-斯托克斯难题
OpenAI宣布其未公开AI模型成功解决千禧年大奖难题之一“纳维-斯托克斯存在性与光滑性问题”,历时88小时,动用约一万个智能体协作生成证明,并由GPT-6 Astra在17小时内完成Lean形式化验证。数学家陶哲轩点赞同时担忧AI对数学理解的潜在影响。
AI研发长寿药物步入人体临床试验
英矽智能利用AI辅助生成的药物Rentosertib在临床试验中显示出减缓衰老的潜力。经6种衰老时钟测量,43名特发性肺纤维化患者用药后预测生物年龄显著下降。这是AI技术进入医疗领域的重要里程碑,但尚需更大规模验证。
AI辅助快速开发微信零点击蠕虫
网络安全企业Calif利用人工智能技术,开发出首个面向微信的零点击蠕虫WeWorm,该蠕虫经通话传播数秒即可接管应用。相关漏洞已在客户端及服务器端修复。Calif指出,AI将原本数月的开发工作压缩至数天,防御方同样需借助AI化解风险。
微信开源多模态嵌入模型并大规模应用
微信开源通用多模态嵌入模型WeMM-Embedding,提供2B、4B、9B三个版本,支持文本、图像、视频等输入。目前该模型已在朋友圈搜索、视频号推荐、公众号推荐、微信电商等场景大规模落地,日调用量达十亿次,并登顶权威评测榜单MMEB-v2。论文、代码和模型均已开放。
DeepSeek V4.1-Flash内测开启原生多模态提速降本
DeepSeek V4.1-Flash开启中间版本内测,引入全新模型结构,实现原生多模态支持,综合能力更强、速度更快、成本更低。开发者仅需修改模型名即可调用,计费标准与V4-Flash一致。此前多模态版本及开源生态亦有显著进展,标志其在多模态与性能优化上迈出关键一步。
微信开源多模态嵌入模型全面领跑国际榜单
微信AI正式开源通用多模态嵌入模型WeMM-Embedding,推出2B、4B及9B三个参数版本,全面支持文本、图像、视频等多种模态输入。该模型在国际权威评测榜单MMEB-v2上综合表现位列第一,超越此前所有开源及闭源商业模型,并已在微信生态核心业务中大规模落地应用,日均调用量突破10亿次。
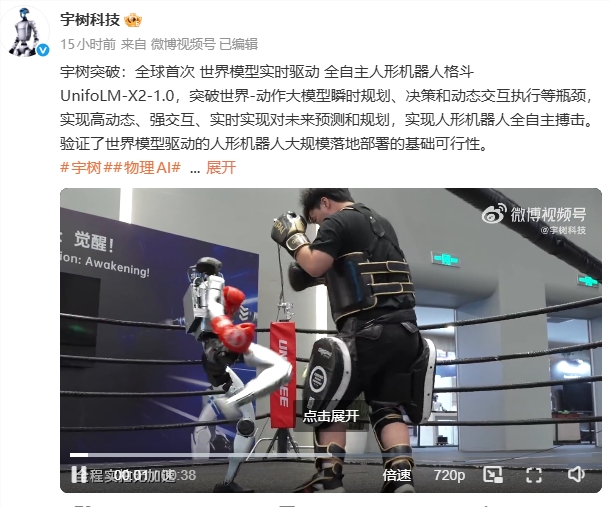
世界模型实时驱动人形机器人实现自主格斗
宇树科技宣布全球首次实现由世界模型实时驱动的全自主人形机器人格斗。基于UnifoLM-X2-1.0模型,突破瞬时规划与动态交互执行瓶颈,验证了世界模型驱动人形机器人规模化落地的可行性,为复杂交互场景应用奠定基础。
GPT-6 Astra零失误通关人机验证关卡
OpenAI最新模型GPT-6 Astra在CAPTCHA“我不是机器人”测试中,零失误完成全部48个游戏关卡,展现多模态理解与交互能力的突破,引发对传统人机验证机制有效性的广泛质疑,并推动新一代身份验证体系探索。