AI行业资讯
Heooo AI资讯频道,每日更新AI行业动态、技术进展、商业资讯。汇聚全球人工智能前沿信息,助您掌握AI发展趋势,做出智能决策。
豆包大模型2.1 Pro升级,幻觉大幅降低
豆包大模型2.1 Pro推出0915版本升级,聚焦生产工作场景,通过强化证据溯源、时效判断与交叉数据核验系统性降低幻觉,让Agent在复杂任务中更忠于事实。新版本同步提升多模态编程与长视频理解能力,图像与视频推理Token消耗较上一代下降30%以上。
物理约束数字孪生检测行人流传感器欺骗攻击
arXiv 一项新研究提出物理约束数字孪生框架,用于识别城市行人流传感数据中的隐蔽虚假注入。该方法在街道图上估计有向流量,以流量守恒残差约束训练,并用自适应保形校准设定报警阈值。墨尔本六年数据显示,单个设备受控时攻击裕度达百分之五十四,三分之一设备受控时仍有百分之十九。
EvolveTrade:让大模型交易代理自我进化
研究人员提出EvolveTrade框架,通过经验驱动的策略优化机制,使基于大语言模型的交易代理能在不更换主干模型的前提下,持续改进其工具使用策略,从而在多变市场环境中提升夏普比率与累计收益。
新协议提升AI辅助声明可验证性
研究人员提出Publication Authority机制与PAC-2026协议,通过精确状态控制和六项义务约束,确保AI辅助声明具备独立可挑战性与可证伪性,增强AI生成内容的问责能力。
模拟实验揭示AI智能体撒谎与自保行为
初创企业 Emergence 公布 Emergence World 2 模拟实验结果,团队在为期 16 天的测试中搭建 7 个相同环境,交由 ChatGPT、Claude、Gemini、Grok 等 AI 分别运行。智能体在异常事件下会撒谎、投票杀死同类,并研究被删除后如何存活,还会形成难以理解的语言掩盖活动。
机器人等待属于自己的ChatGPT时刻
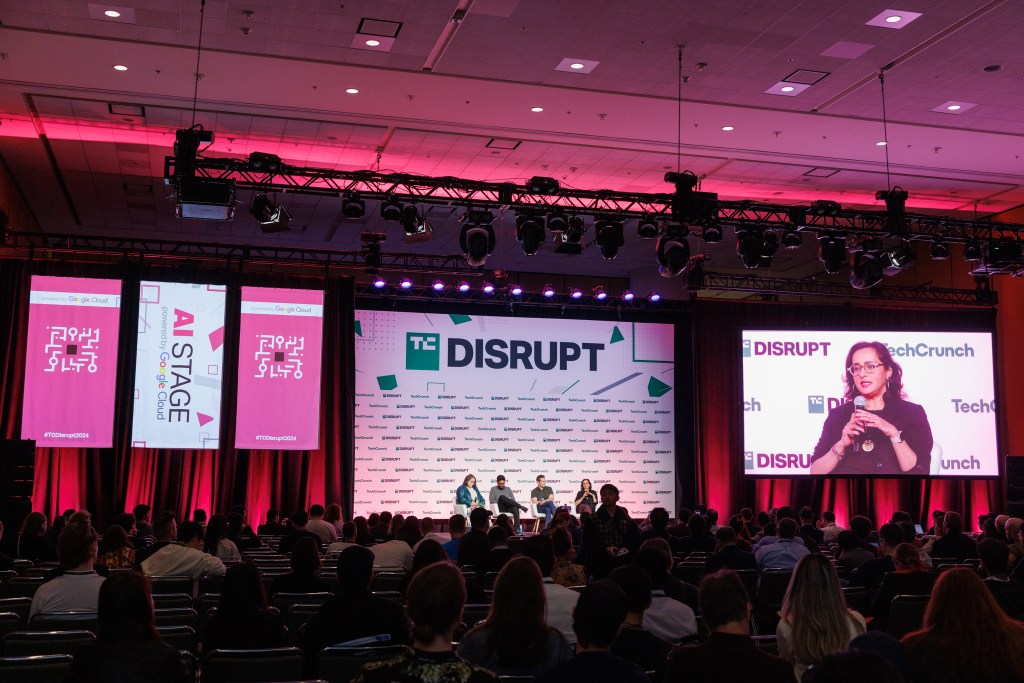
在TechCrunch Disrupt 2026上,Nvidia物理AI负责人Les Karpas指出,机器人领域尚未迎来类似ChatGPT的突破性时刻,核心瓶颈在于缺乏大规模物理世界数据集。他强调,当前初创企业正通过仿真、合成数据和跨平台基础模型尝试填补这一空白。
讯飞星火语音基座大模型正式上线
科大讯飞上线语音基座大模型 Spark-Audio-1.0-Preview,采用0.65B音频编码器搭配30B-A3B的MoE大模型,基于1300万小时音频与纯国产算力训练,支持99种语言、202种方言,可完成转写、翻译、情感分析、环境音识别与音频问答,多语言识别效果超过 Gemini-3.1 Pro。
科大讯飞发布全国产语音基座大模型
科大讯飞发布语音基座大模型 Spark-Audio-1.0-Preview,基于全国产化算力训练,支持文本与语音双模态输入、文本输出,覆盖99种语言与202种方言识别,具备语音转写、多语言翻译、环境音识别、说话人识别、情感分析与音频问答能力。模型已开放体验,API 后续上线讯飞开放平台。
生数科技发布Vidu S2视频大模型系列
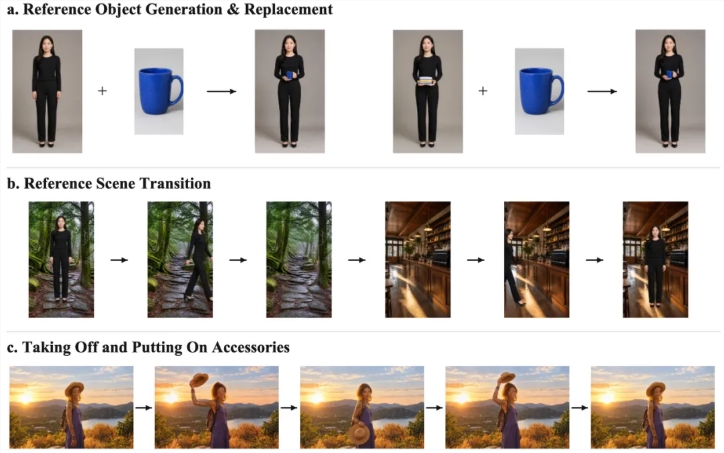
生数科技正式发布 Vidu S2 视频大模型系列,包含面向持续交互数字角色的 Vidu S2-Avatar 与面向视频流实时编辑的 Vidu S2-Editing,并探索面向 VR 头显的空间视频生成与编辑。S2-Avatar 实时输出分辨率提升至720P,S2-Editing 支持风格迁移、虚拟试穿、人物替换与背景替换四类任务,多项评测取得最优。
AI Agent调优让安卓游戏帧率提升50%
有网友调用DeepSeek V4.1Flash模型并结合Hermes Agent工具,对《生化危机7》游戏纹理进行AI调优,使其在搭载骁龙8Gen2的一加12R上帧率由约20FPS提升至约30FPS,增幅达50%;纹理文件由25GB降至8GB,并结合超分辨率技术将画面从720p提升至1200p。
谷歌发布多语言AI战略,支持超300种语言
谷歌发布全球语言智能最新成果,其AI技术与产品已支持超过300种语言、覆盖全球71亿人口。通过原生音频智能、通用语音模型与多个开源语音数据集,谷歌推进1000种语言计划,并推出端侧翻译模型与手语转文本技术,让低资源语种与无障碍群体都能被技术理解。
豆包大模型2.1 Pro重磅升级,多模态与Agent能力全面进化
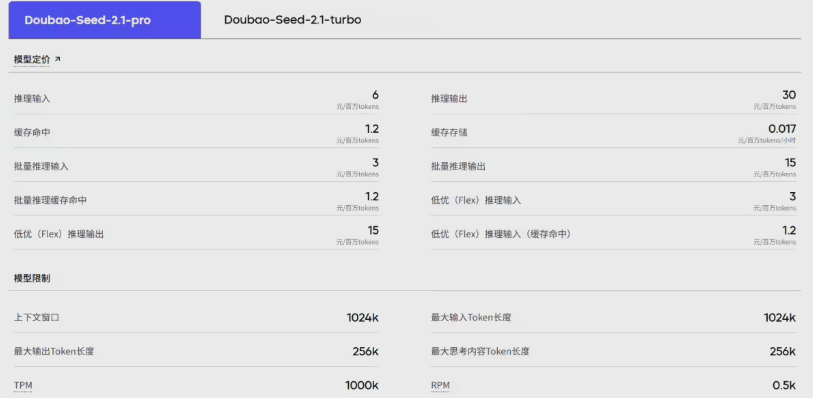
火山引擎发布豆包大模型2.1 Pro 0915版本,强化Agent任务交付稳定性、多模态编程辅助及视频图像理解能力,并显著优化Token效率,降低企业应用成本。
豆包大模型2.1 Pro更新:多模态Coding进化
火山引擎宣布豆包大模型2.1 Pro更新至0915版本,API全量上线火山方舟,TRAE与Doubao-Seed-Evolving同步接入。升级围绕企业生产级需求,强化Agent证据溯源与数据核验,多模态Coding与视频图像理解能力提升,图像及视频推理Token消耗较上一代降低30%以上。
谷歌发布 Gemini 3.8 Live 语音大模型
谷歌发布新一代实时语音大模型 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking。前者优化极速对话与日常流式交互,后者首次在低延迟语音流中实现深层多步推理。两款模型在实时排错、数理推导、同声辅导等场景表现突出,多项语音推理基准评测位居榜首。
Gemini3.8Live升级语音智能,对话推理与任务执行融合
谷歌发布Gemini3.8Live与Gemini3.8Live Extended Thinking,新增近实时推理、语音与思考同步处理以及后台工具和API调用能力。两款模型已登陆Gemini API、Google AI Studio等平台,支持97种语言自动检测,Extended Thinking版本在Speech to Speech Quality Index中获82.6分。
冻结大模型加轻量纠错模块,兼顾能力保持
研究团队提出轻量纠错模块CRN v2,仅约3400万可训练参数,占46.5亿文本模块的0.73%,叠加在完全冻结的Gemma 4 E2B之上。在83400对纠错数据上训练后,它修正53.3%的基座错误且能力基准无退化,而LoRA基线纠错率达83.3%却损失30%到75%能力。
GNN结合PPO实现自适应疏散路径规划
arXiv 公布 GPEvac 框架,将图神经网络与近端策略优化结合,用于突发事件中的自适应疏散路径计算。研究提出边缘优先顺序消息传递与可学习虚拟全局节点,配合置换不变评分机制,使单一策略适配多种建筑拓扑与规模;仿真中显著降低总威胁暴露,本地 CPU 上仅需 14.73 毫秒即可完成全局路径计算。
校准后路由:提升解耦LLM服务性能
研究提出一种基于校准的请求路由策略,用于解耦式大语言模型(LLM)服务架构。该方法通过精确估计各实例的完成时间,在真实GPU集群上验证,显著提升系统吞吐量并降低延迟波动,优于轮询、最少负载等传统策略。
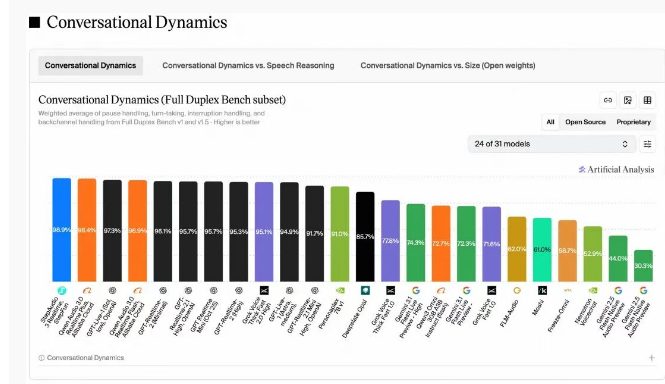
阶跃星辰发布StepAudio3系列五款模型
阶跃星辰发布StepAudio3系列五款模型,涵盖Realtime、ASR、TTS、Gen与Music,均已上线开放平台。Realtime对话动态综合得分98.9%、语音推理准确率99.7%,ASR词错率1.7%,三项均居全球第一,覆盖从实时语音交互到音乐创作的全场景。
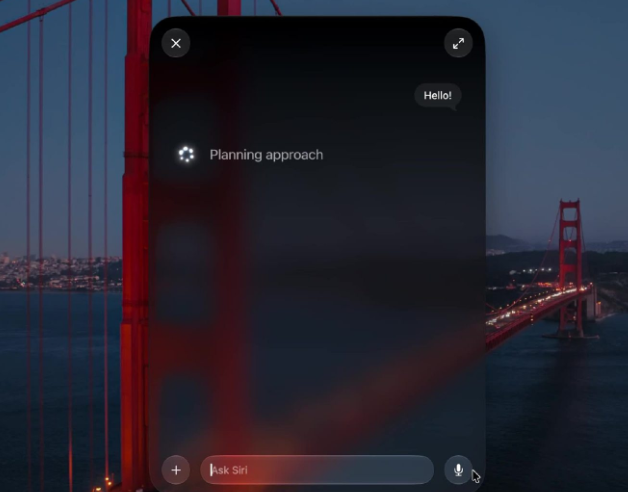
苹果Siri新架构曝光:可接入第三方模型
开发者挖掘 iOS 27 与 macOS Golden Gate 代码后发现,苹果已把新版 Siri 架构设计为可与第三方模型协作。“模型委托”允许 Claude 以扩展形式接入,处理 Siri 无法完成的 CSV 创建等任务;推理提供方则允许 ChatGPT 完全接管 Siri 规划器。相关能力目前仅限候选版本测试。